
AI 数据中心存储架构:HBM、DRAM、SSD、HDD 分别负责什么?




AI 数据中心不是只靠 GPU 和 HBM 运转,而是一套由 HBM、DRAM、SSD、HDD 共同组成的分层存储架构。越靠近计算芯片,越强调带宽、延迟和能效;越接近数据湖和归档层,越强调容量、可靠性和单 TB 成本。你理解这四类存储的分工,就能更清楚地判断 AI 服务器瓶颈、云厂商 CAPEX、存储公司受益顺序,以及 HBM、NAND、HDD 需求为什么会同时被 AI 推动。
核心要点
- HBM 负责贴近 GPU 的高带宽计算,不负责长期保存数据。
- DRAM 承担 CPU 侧系统内存、调度、预处理和缓存承接。
- SSD 负责热数据、模型加载、检查点和高速持久化访问。
- HDD 仍是冷数据、归档、备份和大容量数据湖的成本底座。
- AI 推理会同时增加 HBM、DRAM、SSD 和 HDD 的需求。
- 判断存储股受益顺序,要先看瓶颈发生在哪一层。
AI 数据中心存储架构是什么:从 GPU HBM 到冷数据 HDD

AI 数据中心存储架构是一套分层系统。最靠近 GPU 和 AI 加速器的是 HBM,负责高带宽数据供给;CPU 侧由 DRAM 支撑系统内存和任务调度;服务器和存储节点使用 SSD 保存高频访问数据;更大规模的数据湖、备份和归档则依赖 HDD。四者不是替代关系,而是按速度、容量、成本和访问频率分工协作。
Micron AI data center把 AI 基础设施描述为完整的 memory and storage hierarchy,这个说法很关键:AI 工作负载并不是把所有数据都放进最快的介质,而是让不同数据待在最合适的位置。
| 层级 | 产品 | 靠近对象 | 核心指标 | 主要任务 |
|---|---|---|---|---|
| 第一层 | HBM | GPU / AI 加速器 | 带宽、延迟、功耗 | 模型计算、热 KV Cache、GPU 数据供给 |
| 第二层 | DRAM | CPU / 主机系统 | 容量、延迟、通道数 | 系统内存、调度、预处理、缓存承接 |
| 第三层 | SSD | 服务器 / 存储节点 | IOPS、吞吐、耐久度 | 模型加载、训练数据读取、热数据保存 |
| 第四层 | HDD | 存储集群 / 对象存储 | 单 TB 成本、容量、可靠性 | 数据湖、冷数据、归档、备份 |
为什么不能只看 GPU 和 HBM?因为 AI 训练需要持续读取数据集,SSD 和网络存储会影响 GPU 利用率;AI 推理需要处理用户上下文、日志和缓存,DRAM 与 SSD 会影响吞吐;模型文件、训练数据、监控日志、向量数据和历史交互也不可能长期放在 HBM 中。数据中心真正追求的是单位算力、单位容量和单位能耗之间的平衡。
常见误区有四个:第一,以为 HBM 越多,SSD 就不重要;第二,以为 SSD 价格下降后 HDD 会立刻消失;第三,以为 DRAM 只是传统服务器内存,与 AI 推理关系不大;第四,只看训练,不看推理、日志和数据闭环。实际上,AI 数据中心的数据流是循环的:原始数据进入存储层,被清洗、读取、训练、生成模型,再进入推理服务,推理结果又形成新日志和反馈数据,继续回到存储系统。
小结:AI 数据中心需要分层存储,是因为每种数据的访问频率、延迟要求和成本承受能力不同。HBM 解决 GPU 附近的带宽瓶颈,DRAM 解决系统内存和调度瓶颈,SSD 解决热数据和高速持久化瓶颈,HDD 解决海量数据长期保存的成本瓶颈。理解这张层级图,比单独讨论某一种存储产品更接近真实的数据中心架构。
HBM 负责什么:贴近 GPU 的高带宽计算内存
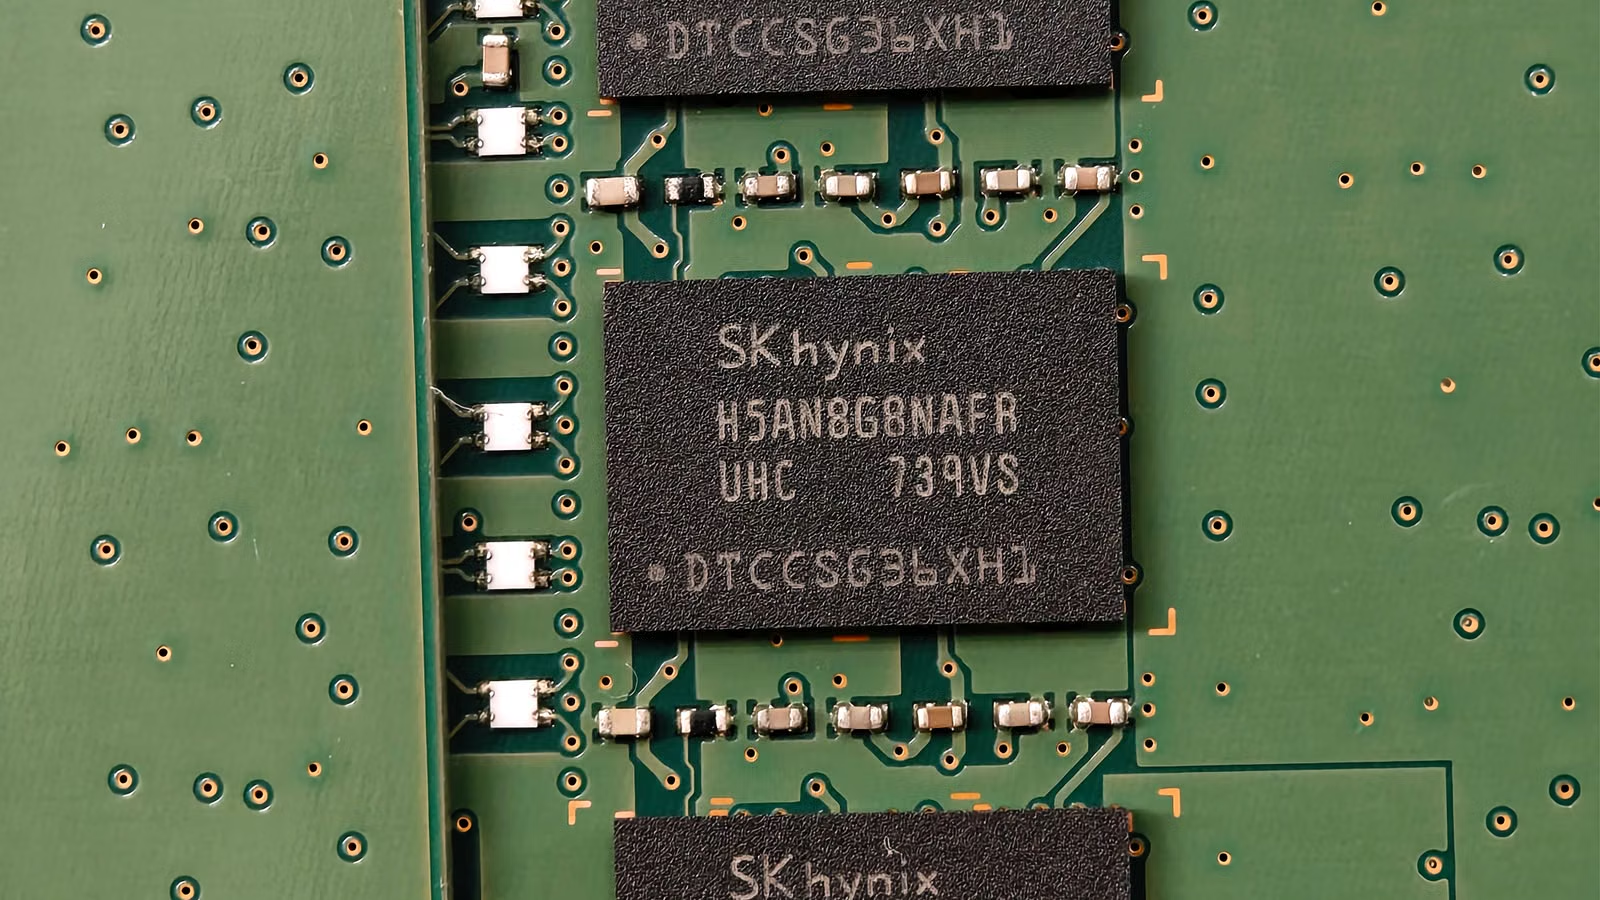
HBM 负责 AI 加速器最前线的数据供给。它不是硬盘,也不是普通服务器内存,而是直接服务 GPU、AI ASIC 和高性能计算芯片的高带宽内存。大模型训练和推理时,计算核心需要不断读取权重、激活值和缓存数据;如果数据供给跟不上,GPU 算力就会等待,HBM 的价值正在于减少这种等待。
HBM 的基本思路,是把多层 DRAM 芯片垂直堆叠,并通过宽接口和先进封装与计算芯片紧密连接。Samsung HBM4E资料显示,下一代 HBM4E 面向 AI、GPU 和高性能计算,目标带宽达到 4.0TB/s 级别。这类指标说明,HBM 竞争重点已经不只是容量,而是带宽、功耗、封装和稳定供货能力。
| AI 环节 | HBM 主要任务 | 为什么不能轻易下放 |
|---|---|---|
| 模型训练 | 存放高频访问的权重、激活值和中间数据 | 对带宽和延迟要求极高 |
| 推理生成 | 支撑模型执行和热 KV Cache | 用户并发会放大带宽压力 |
| 长上下文 | 承载高价值上下文缓存 | 上下文越长,占用越明显 |
| 多 GPU 协同 | 配合高速互连传输数据 | 降低同步等待和通信损耗 |
不过,HBM 的瓶颈不只是价格。它还受到先进制程、堆叠、TSV、封装、测试、良率和客户认证限制。进入 GPU 或 AI ASIC 供应链通常需要长周期验证,供应商不仅要做出样品,还要证明产品能在高功耗、高温、高并发场景下稳定运行。三星、SK 海力士和美光是 HBM 主要供应商,但每家公司在产品代际、良率、客户认证和产能分配上都可能出现差异。
你跟踪 HBM 时,重点不应只看“需求很强”这一句,而应看 HBM3E、HBM4、HBM4E 的量产节奏、单颗容量、带宽、客户认证、封装产能、良率、价格溢价,以及 HBM 收入在存储公司中的占比。如果 HBM 产能紧张且认证顺利,相关公司盈利弹性会更大;如果扩产过快或客户切换方案,估值也可能快速回调。
小结:HBM 是 AI 数据中心中最靠近计算核心的高带宽内存,主要解决 GPU 和 AI 加速器的数据供给问题。它对训练、推理、长上下文和多 GPU 协同都很关键,但受封装、良率、功耗、产能和客户认证制约。HBM 需求增长通常最直接利好具备先进量产能力的存储龙头,而不是所有存储公司都会平均受益。
DRAM 负责什么:CPU 侧系统内存与任务调度缓冲层
DRAM 负责 AI 服务器中 CPU 侧的系统内存、任务编排、数据预处理和缓存承接。它不像 HBM 那样贴近 GPU,但决定服务器能否稳定组织数据、调度请求、管理 I/O、承接部分缓存压力。没有足够 DRAM,GPU 可能拥有强算力,却难以持续获得系统层面的数据和任务支持。
HBM 与 DRAM 的区别可以从位置和任务理解。HBM 在 GPU 或 AI 加速器旁边,追求极高带宽和极低延迟;DRAM 在 CPU 与主机系统侧,追求更大的系统内存容量、更灵活的任务调度和更低单位成本。Micron COMPUTEX 2026资料中提到,HBM 支撑高速模型执行和热 KV Cache,LPDDR 与 DDR 则提供系统内存、编排和长上下文扩展能力。
| 维度 | HBM | DRAM |
|---|---|---|
| 位置 | GPU / AI 加速器旁边 | CPU / 主机系统侧 |
| 核心目标 | 极高带宽、低延迟 | 较大容量、系统调度 |
| 典型用途 | 模型计算、热 KV Cache | 预处理、系统内存、缓存承接 |
| 成本结构 | 单位成本更高 | 单位成本相对更低 |
| 扩展限制 | 受封装和 GPU 平台约束 | 受内存通道、主板和功耗约束 |
AI 推理会增加 DRAM 需求,原因在于推理不只是“跑一次模型”。当用户并发增加、上下文变长、Agent 工作流增多时,系统需要管理更多请求、缓存、网络 I/O、输入预处理和输出日志。KV cache被形容为 AI 模型的短期记忆,输入序列越长,缓存和数据管理压力越大。部分热缓存留在 HBM,部分溢出到 DRAM、SSD 或更低层级,是推理系统常见的架构方向。
DDR5 仍是服务器系统内存的重要基础,LPDDR 可能在低功耗 AI 设备和新型模块中发挥作用,CXL 则提供未来内存扩展与内存池化想象。比如 Marvell CXL switch强调通过机架级内存池化扩展 CPU、GPU、XPU 和其他加速器可用内存,这说明 AI 内存瓶颈已经从单颗芯片扩展到机架和集群层面。
小结:DRAM 是 AI 数据中心的系统内存和缓冲层,负责 CPU 侧调度、数据预处理、请求管理和部分缓存承接。它不如 HBM 靠近 GPU,但对推理并发、长上下文、I/O 管理和服务器稳定运行非常重要。判断 DRAM 需求时,你需要同时看 AI 服务器、传统服务器、PC、手机和数据中心内存扩展趋势,而不能只看 HBM 热度。
SSD 负责什么:热数据、模型文件与高速持久化存储
SSD 在 AI 数据中心中负责高速持久化存储。它比 HBM 和 DRAM 慢,但断电后可以保存数据;它比 HDD 快,但单位容量成本更高。因此,SSD 最适合放置访问频率高、性能敏感、需要快速读取或写入的数据,例如模型文件、训练样本、检查点、热数据、日志和部分持久化 KV Cache。
Solidigm inference context memory storage把 AI 推理中的上下文存储问题描述为新的 flash storage problem,核心意思是:当上下文和缓存规模超出 HBM 与 DRAM,靠近 GPU Pod 的高密度 SSD 会成为扩展推理容量的重要层级。NVIDIA BlueField-4 CMX也把 GPU HBM、系统 DRAM、local/rack-attached storage 放进同一套推理上下文层级中,说明 SSD 不只是普通硬盘替代品,而是 AI 推理架构的一部分。
| AI 工作流 | SSD 作用 | 关键指标 |
|---|---|---|
| 数据准备 | 快速读取和清洗训练数据 | 顺序读取、吞吐 |
| 模型训练 | 保存 checkpoint 和中间结果 | 写入耐久度、延迟 |
| 模型部署 | 快速加载模型权重 | 随机读取、容量 |
| 推理服务 | 支持热数据和日志写入 | IOPS、尾延迟 |
| 数据湖热层 | 保存高价值高频数据 | 成本、扩展性 |
企业级 SSD 与消费级 SSD 的差异也很重要。AI 数据中心更关注持续写入、断电保护、低尾延迟、耐久度、散热和接口形态,而不是只看标称读取速度。U.2、E1.S、E3.S、PCIe Gen5/Gen6、QLC、TLC 等路线,会影响机架密度、能耗和每 TB 成本。高容量 SSD 可以提高单位机架容量和性能密度,但在长期归档和低频访问数据上,成本仍通常高于 HDD。
SSD 不能替代 HBM,因为它的延迟和带宽远低于 GPU 旁边的高带宽内存;也不能替代 DRAM,因为它不适合承担通用系统内存角色。它可以替代部分高频 HDD 工作负载,尤其是模型加载、热数据访问、检查点和缓存扩展场景。投资判断上,SSD 需求要看企业级 SSD 采购、NAND 价格、QLC 渗透、数据中心客户订单、NAND 厂商库存和毛利率,而不是只看 AI 服务器出货。
小结:SSD 是 AI 数据中心中的高速持久化层,主要负责热数据、模型加载、训练数据读取、检查点和日志写入。它连接了“内存层”和“长期存储层”,既不能替代 HBM 和 DRAM,也不能完全取代 HDD。SSD 的核心价值在于在速度、容量和持久化之间取得平衡,尤其适合推理增长带来的上下文与热数据压力。
HDD 负责什么:海量数据、归档、备份和 AI 数据闭环
HDD 在 AI 数据中心中负责大容量、低成本、长期保存的数据层。它不适合替代 HBM、DRAM 或高性能 SSD,但在原始训练数据、历史日志、视频、备份、归档、对象存储和冷数据中仍然关键。AI 产生的数据越多,越需要低成本、可横向扩展的容量底座。
AI 时代 HDD 没有被淘汰,原因很简单:不是所有数据都值得用 SSD 保存。模型训练需要大量原始数据,推理服务会持续产生日志、用户交互、监控数据和反馈数据,多模态 AI 还会产生更多图片、音频和视频文件。这些数据有些需要快速访问,有些只需要长期留存。对于后者,HDD 的容量经济性仍然有意义。Seagate mass-capacity storage强调,AI 规模化需要高容量硬盘支撑大规模数据存储。
| 场景 | 为什么适合 HDD | 是否需要 SSD 配合 |
|---|---|---|
| 原始训练数据 | 容量巨大、访问频率不均 | 热数据需要 SSD 缓存 |
| 模型归档 | 长期保存、调用频率较低 | 部署时可转入 SSD |
| 日志与反馈数据 | 数据持续增长、成本敏感 | 高频日志可先进入 SSD |
| 备份与灾备 | 容量优先、长期保存 | 取决于恢复速度要求 |
| 对象存储 | 横向扩展、容量池化 | 前端可配置缓存层 |
HDD 技术仍在升级。HAMR、ePMR、SMR、UltraSMR 等路线的目标,是提升单盘容量、降低每 TB 成本,并改善数据中心能耗和空间效率。Western Digital AI era storage innovation提到 UltraSMR、ePMR、HAMR 与软件抽象层,目标是服务 AI 规模工作负载。Seagate 32TB drives也显示,大容量 HDD 仍在面向 AI 视频、NAS 和数据中心场景迭代。
HDD 的投资逻辑与 HBM 不同。HBM 看带宽、封装和客户认证;HDD 看单盘容量、云客户采购、每 TB 成本、产能纪律和毛利率。AI 数据中心一边追求更快的推理,一边产生更多数据,最终形成“计算—生成—保存—再训练”的闭环。这个闭环越大,冷数据和近线存储的重要性越不容易消失。
小结:HDD 是 AI 数据中心的容量底座,负责长期保存、归档、备份、冷数据和对象存储。它不追求最低延迟,也不承担高带宽计算任务,但在每 TB 成本和大规模容量扩展上仍有优势。SSD 与 HDD 不是简单替代关系,SSD 管热数据和高速访问,HDD 管长期数据和容量经济性。
从存储架构看投资逻辑:如何判断 HBM、DRAM、SSD、HDD 的受益顺序
从投资角度看,HBM、DRAM、SSD、HDD 谁更受益,取决于 AI 需求卡在哪一层。如果瓶颈是 GPU 数据供给,HBM 最直接;如果瓶颈是推理并发和系统调度,DRAM 重要性上升;如果瓶颈是模型加载和热数据,SSD 更相关;如果瓶颈是数据长期保存和成本,HDD 更关键。
| 瓶颈 | 更相关产品 | 公司类型 | 观察重点 |
|---|---|---|---|
| 带宽瓶颈 | HBM | 存储芯片龙头 | HBM 份额、认证、良率 |
| 系统内存瓶颈 | DDR5 / DRAM | DRAM 厂商 | 服务器内存价格、产能分配 |
| 热数据瓶颈 | 企业级 SSD | NAND 与 SSD 厂商 | 企业 SSD 需求、NAND 价格 |
| 容量成本瓶颈 | Nearline HDD | HDD 厂商 | 云客户长约、单盘容量 |
| 架构效率瓶颈 | 分层存储系统 | 企业存储平台 | 软件、缓存、数据管理能力 |
AI 训练和 AI 推理的受益路径也不一样。训练更依赖 GPU、HBM、训练数据读取和 checkpoint 保存;推理更依赖并发、上下文缓存、热数据访问和日志保存。多模态 AI 会增加图片、视频、音频等大文件存储;Agent 工作流和企业知识库会增加向量数据、交互记录和长期上下文需求。长期看,推理常态化可能让 SSD 和 HDD 需求更稳定,而 HBM 更容易受单代 GPU 平台和客户认证节奏影响。
投资者最容易犯的错误,是把所有“AI 存储”都归为同一逻辑。存储芯片公司、企业级 SSD 厂商、HDD 厂商和企业存储系统公司,财务弹性和估值逻辑并不一样。你需要同时看产品位置、价格周期、库存变化、产能扩张、客户集中度和交易成本。
如果你关注 AI 数据中心存储链条中的 HBM、DRAM、SSD、HDD 标的,除了判断产业趋势,也需要评估实际交易成本。美股交易成本通常不只包括佣金,还可能包括平台费、外部机构费、交易活动费、买卖价差和汇率转换成本。你可以用美股信息查询比较美光、西部数据、希捷、三星 ADR 或相关 ETF 的行情,再结合Biya 美股交易费用核对佣金、平台费、外部机构费和订单展示费用。Biya 美股交易佣金为 0 美元,平台费、外部机构费及其他费用以费用说明和订单页面展示为准。
小结:AI 存储投资分析不能只看 HBM,也不能只看“数据量增长”。HBM 对应带宽,DRAM 对应系统内存和推理承接,SSD 对应热数据和高速持久化,HDD 对应容量经济性和长期保存。真正有效的判断,是先定位数据中心瓶颈,再映射到产品、公司、价格周期、估值和实际交易成本。
理解 AI 数据中心存储架构时,你可以把 HBM、DRAM、SSD、HDD 放到同一张分层图中,而不是只追逐单一热点。越靠近 GPU,越看带宽和延迟;越靠近数据湖,越看容量和成本。如果你想进一步比较美股和港股中的存储芯片、企业级 SSD、HDD 和数据中心基础设施公司,可以通过Biya查看相关资产,并用港股信息查询补充观察亚洲半导体和硬件标的;也可以下载 Biya App管理关注列表和交易记录。相关服务是否可用,取决于用户所在地、身份验证结果、平台规则及适用法律法规。公开市场信息、交易规则和费用结构仅用于分析参考,不构成投资建议。
FAQ
AI 数据中心为什么同时需要 HBM 和 DRAM?
AI 数据中心同时需要 HBM 和 DRAM,因为两者位置和任务不同。HBM 主要服务 GPU 高带宽计算,DRAM 主要服务 CPU 侧系统内存、调度、预处理和缓存承接。HBM 更快但更贵,DRAM 更适合承担系统级容量和灵活调度。
AI 推理增长会增加 SSD 需求吗?
会。AI 推理增长会带来模型加载、热数据访问、日志写入、用户上下文保存和部分持久化缓存需求。SSD 在速度、容量和断电保存之间取得平衡,适合承担热数据层,但具体需求仍取决于模型架构、并发规模和缓存策略。
HDD 在 AI 数据中心还有投资价值吗?
HDD 在 AI 数据中心仍有条件存在投资价值。它不适合高带宽计算,也不适合低延迟热数据访问,但在原始数据、归档、备份、冷数据和对象存储中具备每 TB 成本优势。判断时应结合云客户采购、单盘容量和毛利率。
HBM 需求增长是否一定利好所有存储公司?
不一定。HBM 需求主要利好具备先进 HBM 量产、封装合作、良率控制和客户认证能力的厂商。普通 NAND、HDD 或利基型存储公司受益路径不同,不能简单归入同一逻辑。投资前应查看具体产品结构和收入占比。
普通投资者如何跟踪 AI 存储周期?
普通投资者可以重点跟踪 HBM 认证进度、DRAM 与 NAND 价格、企业级 SSD 采购、Nearline HDD 出货容量、云厂商 CAPEX 和存储公司毛利率。单一指标不足以判断完整周期,最好结合价格、库存、产能和估值一起观察。
AI 数据中心存储架构会影响 ETF 选择吗?
会。偏 HBM 和 DRAM 的 ETF 更受存储芯片价格周期影响,覆盖 SSD、HDD 或企业存储系统公司的基金则更偏容量和数据中心基础设施逻辑。选择前应查看持仓、费用率、地域暴露、集中度和风险披露。
*本文仅供参考,不构成 BiyaPay 或其子公司及其关联公司的法律,税务或其他专业建议,也不能替代财务顾问或任何其他专业人士的建议。
我们不以任何明示或暗示的形式陈述,保证或担保该出版物中内容的准确性,完整性或时效性。
其他BiyaPay博客内容
国际汇款怎样更省钱?小额与大额转账的不同选择

适合新手的加密货币 App:费用、安全与易用性比较


 澳大利亚
 奥地利
 比利时
 加拿大
 塞浦路斯
 捷克
 丹麦
 爱沙尼亚
 芬兰
 法国
 德国
 希腊
 香港
 印度
 印度尼西亚
 爱尔兰
 意大利
 日本
 拉脱维亚
 立陶宛
 卢森堡
 马来西亚
 马耳他
 摩洛哥
 尼泊尔
 荷兰
 新西兰
 挪威
 巴基斯坦
 菲律宾
 波兰
 葡萄牙
 罗马尼亚
 新加坡
 斯洛伐克
 斯洛文尼亚
 南非
 韩国
 西班牙
 瑞典
 泰国
 美国
 土耳其
 阿联酋
 英国
 越南