
Senibina Storan Pusat Data AI: Apakah Fungsi HBM, DRAM, SSD, dan HDD?




Pusat data AI tidak beroperasi hanya dengan GPU dan HBM semata-mata. Ia bergantung pada seni bina storan berlapis yang terdiri daripada HBM, DRAM, SSD, dan HDD. Semakin dekat sesuatu lapisan storan kepada cip pengiraan, semakin ia menekankan lebar jalur, kependaman, dan kecekapan kuasa. Semakin dekat ia kepada lapisan tasik data dan arkib, semakin ia menekankan kapasiti, kebolehpercayaan, dan kos setiap terabait. Setelah anda memahami bagaimana keempat-empat jenis storan ini membahagikan tanggungjawab, anda dapat menilai dengan lebih baik kesesakan pelayan AI, CAPEX awan, susunan syarikat memori yang mungkin mendapat manfaat, dan sebab AI boleh merangsang permintaan untuk HBM, NAND, dan HDD secara serentak.
Poin Penting
- HBM mengendalikan pengiraan lebar jalur tinggi berhampiran GPU, bukan penyimpanan data jangka panjang.
- DRAM menyokong memori sistem di sisi CPU, penjadualan, pra-pemprosesan, dan limpahan cache.
- SSD mengendalikan data panas, pemuatan model, checkpoint, dan akses berterusan berkelajuan tinggi.
- HDD kekal sebagai asas kos untuk data sejuk, pengarkiban, sandaran, dan tasik data berkapasiti besar.
- Inferens AI boleh meningkatkan permintaan untuk HBM, DRAM, SSD, dan HDD pada masa yang sama.
- Untuk menilai segmen penyimpanan mana yang mendapat manfaat lebih dahulu, anda perlu mengenal pasti di mana kesesakan berlaku.
Apakah Seni Bina Penyimpanan Pusat Data AI: Dari HBM GPU hingga HDD Data Sejuk
Arkitektur storan pusat data AI ialah sistem berlapis. HBM terletak paling hampir dengan GPU dan pemecut AI, menyediakan penghantaran data berjalur lebar tinggi. DRAM di bahagian CPU menyokong memori sistem dan penjadualan tugas. SSD dalam pelayan dan nod storan menyimpan data yang kerap diakses. Tasik data berskala lebih besar, sandaran, dan arkib bergantung pada HDD. Keempat-empat lapisan ini bukan pengganti antara satu sama lain. Ia bekerjasama berdasarkan kelajuan, kapasiti, kos, dan kekerapan akses.
Pusat data AI Micron menggambarkan infrastruktur AI sebagai hierarki memori dan storan yang lengkap. Pendekatan ini penting: beban kerja AI tidak meletakkan semua data dalam medium terpantas. Sebaliknya, pelbagai jenis data diletakkan di tempat yang paling sesuai.
| Lapisan | Produk | Paling Hampir Dengan | Metrik Utama | Tugas Utama |
|---|---|---|---|---|
| Lapisan 1 | HBM | GPU / pemecut AI | Lebar jalur, kependaman, kuasa | Pengiraan model, cache KV panas, penyampaian data GPU |
| Lapisan 2 | DRAM | CPU / sistem hos | Kapasiti, kependaman, bilangan saluran | Memori sistem, penjadualan, prapemprosesan, limpahan cache |
| Lapisan 3 | SSD | Pelayan / nod storan | IOPS, throtiput, ketahanan | Pemuatan model, bacaan data latihan, storan data panas |
| Lapisan 4 | HDD | Kelompok storan / storan objek | Kos setiap TB, kapasiti, kebolehpercayaan | Tasik data, data sejuk, pengarkiban, sandaran |
Mengapa anda tidak sepatutnya memberi tumpuan hanya kepada GPU dan HBM? Latihan AI perlu membaca set data secara berterusan, jadi SSD dan storan berrangkaian mempengaruhi kadar penggunaan GPU. Inferens AI perlu memproses konteks pengguna, log, dan cache, jadi DRAM dan SSD mempengaruhi throughput. Fail model, data latihan, log pemantauan, data vektor, dan interaksi sejarah juga tidak dapat kekal dalam HBM untuk jangka masa panjang. Pusat data sebenar direka untuk mengimbangi kos pengiraan, kapasiti, dan tenaga.
Terdapat empat salah faham yang biasa. Pertama, lebih banyak HBM tidak menjadikan SSD tidak relevan. Kedua, SSD yang lebih murah tidak serta-merta menghapuskan HDD. Ketiga, DRAM bukan sekadar memori pelayan tradisional; ia penting untuk inferens AI. Keempat, permintaan storan AI tidak hanya datang daripada latihan. Ia juga datang daripada inferens, log, dan gelung maklum balas data. Dalam praktiknya, aliran data AI adalah berbentuk bulatan: data mentah memasuki lapisan storan, dibersihkan, dibaca, digunakan untuk latihan, dan ditukar menjadi model; model tersebut kemudiannya digunakan untuk inferens, dan hasil inferens menjana log baharu serta data maklum balas yang kembali ke sistem storan.
Ringkasan: Pusat data AI memerlukan storan berlapis kerana jenis data yang berbeza mempunyai kekerapan akses, keperluan kependaman dan kekangan kos yang berbeza. HBM menyelesaikan kesesakan lebar jalur berhampiran GPU. DRAM menyelesaikan kesesakan memori sistem dan penjadualan. SSD menyelesaikan kesesakan data panas dan keberlanjutan berkelajuan tinggi. HDD menyelesaikan kesesakan kos storan data berskala besar jangka panjang. Memahami seni bina berlapis ini lebih realistik daripada menganalisis mana-mana produk storan secara berasingan.
Apa Fungsi HBM: Memori Berlebar Jalur Tinggi Berhampiran GPU
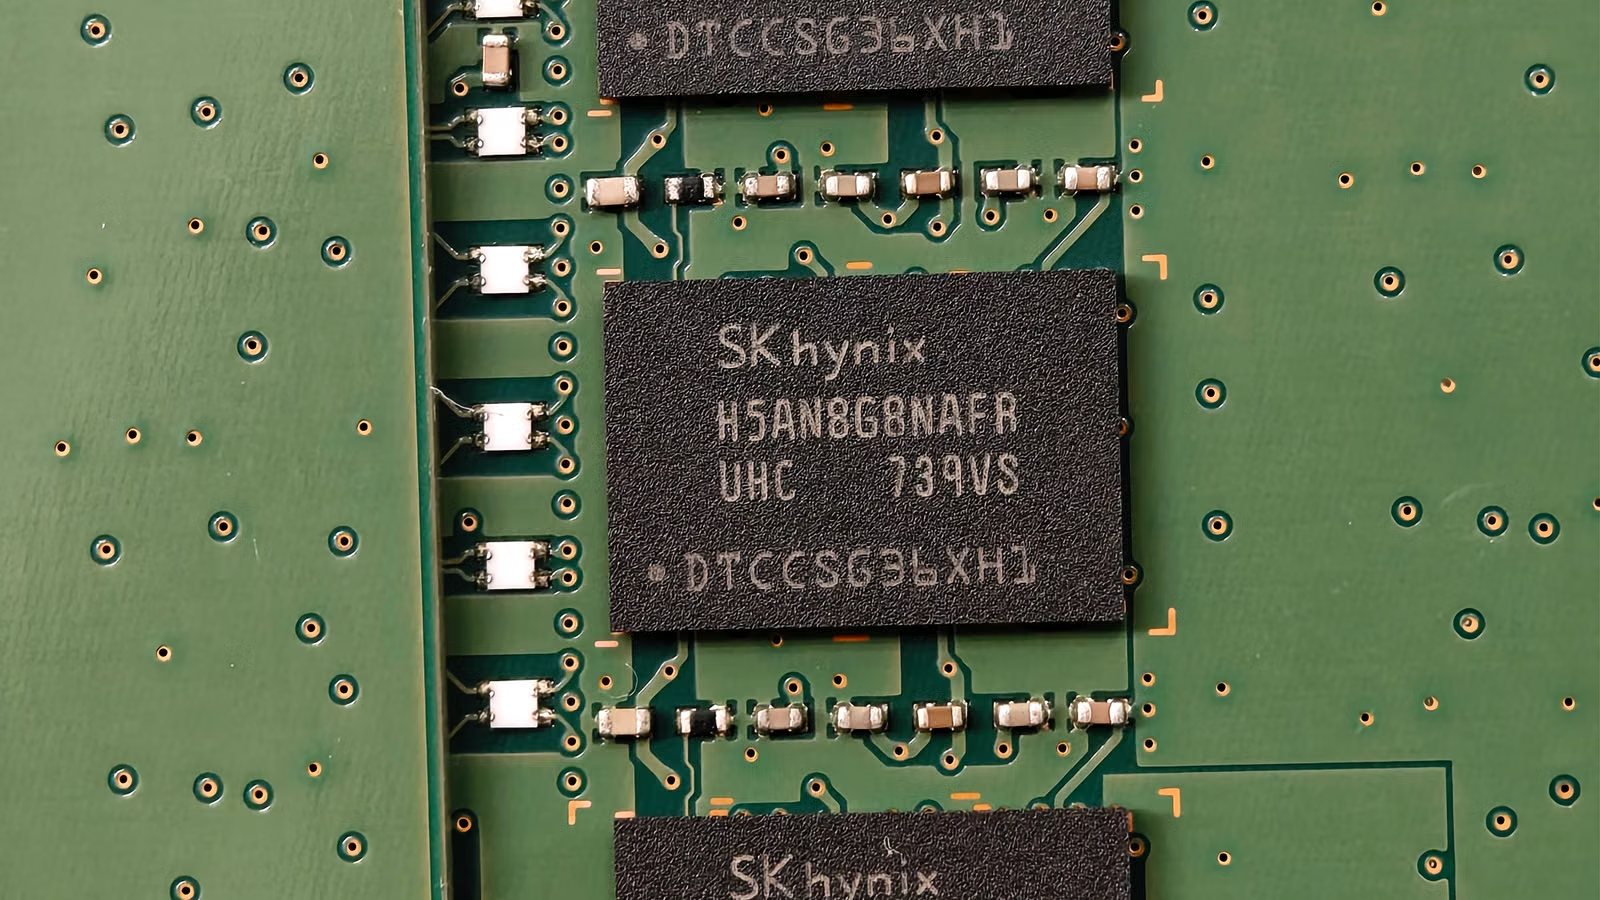
HBM mengendalikan penghantaran data di barisan hadapan untuk pemecut AI. Ia bukan cakera keras, mahupun ingatan pelayan biasa. Ia adalah ingatan jalur lebar tinggi yang berkhidmat secara langsung untuk GPU, ASIC AI, dan cip pengkomputeran berprestasi tinggi. Semasa latihan dan inferens model besar, teras pengkomputeran sentiasa membaca pemberat, pengaktifan, dan data cache. Jika bekalan data tidak dapat menampung, kapasiti pengkomputeran GPU akan terbiar. Nilai HBM terletak pada pengurangan masa menunggu tersebut.
Idea asas di sebalik HBM ialah untuk menyusun die DRAM secara menegak dan menyambungkannya kepada cip pengkomputeran melalui antara muka yang lebar serta pembungkusan termaju. Bahan Samsung HBM4E menunjukkan bahawa HBM4E generasi akan datang menyasarkan AI, GPU, dan pengkomputeran berprestasi tinggi, dengan lebar jalur pada tahap 4.0 TB/s. Metrik ini menunjukkan bahawa persaingan HBM bukan lagi semata-mata mengenai kapasiti. Ia juga mengenai lebar jalur, penggunaan kuasa, pembungkusan, dan bekalan yang stabil.
| Peringkat AI | Tugas Utama HBM | Sebab Ia Tidak Mudah Dipindahkan Ke Bawah |
|---|---|---|
| Latihan model | Menyimpan pemberat, pengaktifan, dan data perantaraan yang kerap diakses | Lebar jalur yang sangat tinggi dan kependaman yang rendah diperlukan |
| Penjanaan inferens | Menyokong pelaksanaan model dan cache KV yang aktif | Persamaan pengguna menguatkan tekanan lebar jalur |
| Konteks panjang | Membawa cache konteks bernilai tinggi | Tetingkap konteks yang lebih panjang meningkatkan penggunaan memori |
| Penyelarasan berbilang GPU | Bekerjasama dengan sambungan berkelajuan tinggi untuk memindahkan data | Mengurangkan masa menunggu penyegerakan dan kehilangan komunikasi |
Walau bagaimanapun, kebuntuan HBM bukan sahaja berkaitan harga. Ia juga dihadkan oleh teknologi proses termaju, penimbunan (stacking), TSV, pembungkusan, pengujian, hasil pengeluaran, dan kelayakan pelanggan. Memasuki rantaian bekalan GPU atau AI ASIC biasanya memerlukan kitaran pengesahan yang panjang. Pembekal bukan sahaja perlu menghasilkan sampel, malah perlu membuktikan bahawa produk mereka boleh beroperasi dengan boleh dipercayai dalam keadaan kuasa tinggi, suhu tinggi, dan konkurensi tinggi. Samsung, SK hynix, dan Micron ialah pembekal HBM utama, tetapi setiap syarikat mungkin berbeza dari segi generasi produk, hasil pengeluaran, pensijilan pelanggan, dan peruntukan kapasiti.
Apabila menjejaki HBM, anda tidak sepatutnya hanya memandang frasa "permintaan yang kuat." Penunjuk yang lebih berguna termasuk garis masa pengeluaran HBM3E, HBM4, dan HBM4E, kapasiti setiap pakej, lebar jalur, pensijilan pelanggan, kapasiti pembungkusan, hasil, premium harga, serta pendapatan HBM sebagai peratusan perniagaan setiap syarikat memori. Jika bekalan HBM ketat dan kelayakan pelanggan berjalan dengan lancar, daya tuai pendapatan boleh menjadi lebih kuat. Jika pengembangan terlalu pantas atau pelanggan menukar reka bentuk, penilaian juga boleh menyesuaikan diri dengan cepat.
Ringkasan: HBM ialah lapisan memori berjalur lebar tinggi yang paling hampir dengan teras pengkomputeran dalam pusat data AI. Ia terutamanya menyelesaikan penyampaian data untuk GPU dan pemecut AI. Ia penting untuk latihan, inferens, konteks panjang, dan penyelarasan berbilang GPU, tetapi ia terhad oleh pembungkusan, hasil pengeluaran, kuasa, kapasiti, dan kelayakan pelanggan. Pertumbuhan permintaan HBM biasanya paling banyak memberi manfaat secara langsung kepada pemimpin memori termaju dengan keupayaan pengeluaran besar yang kukuh; bukan setiap syarikat storan mendapat manfaat yang sama.
Apakah Fungsi DRAM: Memori Sistem di Sisi CPU dan Lapisan Penimbal Penjadualan
DRAM menyokong memori sistem di sisi CPU, orkestrasi tugasan, prapemprosesan data, dan limpahan cache dalam pelayan AI. Ia tidak semedan dengan GPU seperti HBM, tetapi ia menentukan sama ada pelayan dapat menyusun data, menjadualkan permintaan, mengurus I/O, dan menyerap sebahagian tekanan cache. Tanpa DRAM yang mencukupi, GPU mungkin mempunyai kuasa pengiraan yang kuat tetapi kekurangan sokongan data dan tugasan pada peringkat sistem yang stabil.
Perbezaan antara HBM dan DRAM boleh difahami melalui lokasi dan fungsi. HBM terletak di sebelah GPU atau pemecut AI dan mengutamakan bandwidth yang amat tinggi serta kependaman yang rendah. DRAM terletak di bahagian CPU dan sistem hos serta mengutamakan kapasiti memori sistem yang lebih besar, penjadualan tugas yang lebih fleksibel, dan kos seunit yang lebih rendah. Bahan Micron COMPUTEX 2026 menyebut bahawa HBM menyokong pelaksanaan model berkelajuan tinggi dan cache KV yang aktif, manakala LPDDR dan DDR menyokong memori sistem, orkestrasi, dan pengembangan konteks panjang.
| Dimensi | HBM | DRAM |
|---|---|---|
| Lokasi | Di sebelah GPU / pemecut AI | Sisi CPU / sistem hos |
| Matlamat utama | Lebar jalur sangat tinggi dan kependaman rendah | Kapasiti lebih besar dan penjadualan sistem |
| Kegunaan tipikal | Pengiraan model, cache KV panas | Prapemprosesan, memori sistem, limpahan cache |
| Struktur kos | Kos seunit lebih tinggi | Kos seunit relatif lebih rendah |
| Had penskalaan | Dihadkan oleh pembungkusan dan platform GPU | Dihadkan oleh saluran memori, reka bentuk papan induk, dan kuasa |
Inferens AI meningkatkan permintaan DRAM kerana inferens bukan sekadar "menjalankan model sekali sahaja." Apabila serentakan pengguna meningkat, tetingkap konteks menjadi lebih panjang, dan aliran kerja ejen bertambah, sistem harus menguruskan lebih banyak permintaan, cache, I/O rangkaian, prapemprosesan input, dan log output. KV cache sering digambarkan sebagai memori jangka pendek bagi model AI. Semakin panjang urutan input, semakin besar tekanan cache dan pengurusan data. Sebahagian cache panas kekal dalam HBM, manakala sebahagian mungkin melimpah ke DRAM, SSD, atau peringkat yang lebih rendah. Ini merupakan arah yang biasa dalam seni bina sistem inferens.
DDR5 kekal sebagai asas utama untuk memori sistem pelayan. LPDDR mungkin memainkan peranan dalam peranti AI berkuasa rendah dan format modul baharu. CXL menawarkan kemungkinan masa hadapan untuk pengembangan memori dan pemuktamatan memori (memory pooling). Sebagai contoh, suis CXL Marvell mengetengahkan pemuktamatan memori peringkat rak untuk mengembangkan memori yang tersedia untuk CPU, GPU, XPU dan pemecut lain. Ini menunjukkan bahawa kesesakan memori AI sedang berkembang daripada cip individu kepada rak dan kelompok.
Ringkasan: DRAM ialah lapisan memori sistem dan penampan dalam pusat data AI. Ia menyokong penjadualan di sisi CPU, prapemprosesan data, pengurusan permintaan, dan limpahan cache separa. Ia tidak sedekat GPU berbanding HBM, tetapi ia penting bagi serentakan inferens, konteks panjang, pengurusan I/O, dan operasi pelayan yang stabil. Untuk menilai permintaan DRAM, anda perlu mempertimbangkan pelayan AI, pelayan tradisional, PC, telefon pintar, dan trend pengembangan memori pusat data—bukan sekadar momentum HBM sahaja.
Apa Fungsi SSD: Data Panas, Fail Model, dan Storan Kekal Berkelajuan Tinggi
SSD mengendalikan storan berterusan berkelajuan tinggi dalam pusat data AI. Ia lebih perlahan berbanding HBM dan DRAM, tetapi ia dapat menyimpan data selepas bekalan kuasa terputus. Ia lebih pantas berbanding HDD, tetapi kosnya bagi setiap unit kapasiti lebih tinggi. Oleh itu, SSD paling sesuai untuk data yang kerap diakses dan sensitif terhadap prestasi yang perlu dibaca atau ditulis dengan pantas, seperti fail model, sampel latihan, checkpoint, data panas, log, dan sebahagian KV cache berterusan.
Pengestoran memori konteks inferens Solidigm menerangkan penstoran konteks dalam inferens AI sebagai masalah baharu storan kilat. Idea terasnya ialah apabila konteks dan cache berkembang melebihi HBM dan DRAM, SSD berketumpatan tinggi yang berhampiran dengan pod GPU menjadi lapisan penting untuk mengembangkan kapasiti inferens. NVIDIA BlueField-4 CMX juga meletakkan HBM GPU, DRAM sistem, dan storan tempatan atau yang dilekat pada rak dalam hierarki memori konteks inferens yang sama. Ini menunjukkan bahawa SSD bukan sekadar pengganti kepada pemacu keras tradisional. Ia adalah sebahagian daripada seni bina inferens AI.
| Aliran Kerja AI | Peranan SSD | Metrik Utama |
|---|---|---|
| Persediaan data | Membaca dan membersihkan data latihan dengan cepat | Baca berjujukan, keluaran daya |
| Latihan model | Menyimpan titik semak dan hasil pertengahan | Ketahanan tulis, kependaman |
| Pelaksanaan model | Memuatkan berat model dengan cepat | Baca rawak, kapasiti |
| Perkhidmatan inferens | Menyokong data panas dan penulisan log | IOPS, kependaman ekor |
| Lapisan panas tasik data | Menyimpan data bernilai tinggi yang kerap diakses | Kos, skalabiliti |
Perbezaan antara SSD perusahaan dan SSD pengguna juga penting. Pusat data AI lebih mementingkan penulisan berterusan, perlindungan kehilangan kuasa, tail latency yang rendah, ketahanan, haba, dan faktor bentuk berbanding sekadar kelajuan baca pada barisan hadapan. U.2, E1.S, E3.S, PCIe Gen5/Gen6, QLC, dan TLC semuanya mempengaruhi kepadatan rak, penggunaan tenaga, dan kos setiap terabait. SSD berkapasiti tinggi boleh meningkatkan kapasiti setiap rak dan kepadatan prestasi, tetapi untuk data arkib jangka panjang dan akses frekuensi rendah, kosnya masih biasanya lebih tinggi berbanding HDD.
SSD tidak dapat menggantikan HBM kerana latensi dan lebar jalurnya jauh lebih rendah daripada memori lebar jalur tinggi di sebelah GPU. Ia juga tidak dapat menggantikan DRAM kerana ia tidak sesuai sebagai memori sistem serbaguna. SSD dapat menggantikan sebahagian beban kerja HDD berfrekuensi tinggi, terutamanya dalam pemuatan model, akses data panas, checkpointing, dan pengembangan cache. Dari sudut pandangan pelaburan, permintaan SSD harus dinilai melalui perolehan SSD perusahaan, penetapan harga NAND, penggunaan QLC, pesanan pelanggan pusat data, inventori NAND, dan margin kasar—bukan hanya penghantaran pelayan AI sahaja.
Ringkasan: SSD ialah lapisan gigih berkelajuan tinggi dalam pusat data AI. Ia terutamanya mengendalikan data panas, pemuatan model, bacaan data latihan, checkpoint, dan penulisan log. Ia menghubungkan lapisan memori dengan lapisan storan jangka panjang. Ia tidak boleh menggantikan HBM atau DRAM, mahupun dapat menggantikan HDD sepenuhnya. Nilai teras SSD ialah mengimbangi kelajuan, kapasiti, dan ketekalan, terutamanya dalam konteks tekanan konteks dan data panas yang dihasilkan oleh pertumbuhan inferens.
Apa Fungsi HDD: Data Jisim, Pengarkiban, Sandaran, dan Kitaran Data AI
HDD mengendalikan lapisan data berkapasiti besar, berkos rendah, dan jangka panjang dalam pusat data AI. Ia tidak sesuai untuk menggantikan HBM, DRAM, atau SSD berprestasi tinggi, tetapi ia tetap penting untuk data latihan mentah, log sejarah, video, sandaran, pengarkiban, storan objek, dan data sejuk. Semakin banyak data yang dihasilkan oleh AI, semakin banyak ia memerlukan asas kapasiti berkos rendah yang boleh diskala secara mendatar.
HDD belum tersingkir dalam era AI atas satu sebab yang mudah: bukan semua data layak disimpan pada SSD. Latihan model memerlukan jumlah data mentah yang besar. Perkhidmatan inferens sentiasa menjana log, interaksi pengguna, data pemantauan, dan data maklum balas. AI pelbagai mod turut menghasilkan lebih banyak fail imej, audio, dan video. Sesetengah set data ini memerlukan akses pantas; yang lain hanya memerlukan penyimpanan jangka panjang. Bagi yang terakhir, kelebihan ekonomi kapasiti HDD masih penting. Storan kapasiti besar Seagate menekankan bahawa penskalaan AI memerlukan pemacu keras berkapasiti tinggi untuk menyokong penyimpanan data berskala besar.
| Senario | Kenapa HDD Sesuai | Perlukah Sokongan SSD? |
|---|---|---|
| Data latihan mentah | Kapasiti besar, frekuensi akses tidak sekata | Data panas memerlukan caching SSD |
| Pengarkiban model | Penyimpanan jangka panjang, frekuensi akses rendah | Boleh dipindahkan ke SSD semasa pelaksanaan |
| Log dan data maklum balas | Pertumbuhan data berterusan, sensitif kos | Log berfrekuensi tinggi boleh masuk SSD dahulu |
| Sandaran dan pemulihan bencana | Keutamaan kapasiti, penyimpanan jangka panjang | Bergantung pada keperluan kelajuan pemulihan |
| Penyimpanan objek | Penskalaan mendatar dan kapasiti terkumpul | Lapisan cache bahagian hadapan boleh menggunakan SSD |
Teknologi HDD terus bertambah baik. HAMR, ePMR, SMR, dan UltraSMR bertujuan untuk meningkatkan kapasiti setiap pemacu, mengurangkan kos setiap terabait, dan meningkatkan kecekapan tenaga serta ruang pusat data. Inovasi storan era AI Western Digital mengetengahkan UltraSMR, ePMR, HAMR, dan lapisan abstraksi perisian untuk beban kerja berskala AI. Pemacu 32TB Seagate juga menunjukkan bahawa HDD berkapasiti tinggi terus berkembang untuk kes penggunaan video AI, NAS, dan pusat data.
Logik pelaburan untuk HDD berbeza daripada HBM. HBM berkisar tentang lebar jalur, pembungkusan, dan pensijilan pelanggan. HDD pula berkisar tentang kapasiti setiap cakera, pembelian pelanggan awan, kos setiap terabait, disiplin kapasiti, dan margin kasar. Pusat data AI sedang mengejar inferens yang lebih pantas pada masa yang sama menjana lebih banyak data, mewujudkan satu gelung pengiraan, penjanaan, penyimpanan, dan latihan semula. Apabila gelung ini semakin besar, semakin sukar data sejuk dan penyimpanan nearline untuk hilang.
Ringkasan: HDD ialah asas kapasiti pusat data AI. Ia mengendalikan penyimpanan jangka panjang, pengarkiban, sandaran, data sejuk, dan storan objek. Ia tidak bertujuan untuk mencapai kependaman terendah atau mengendalikan pengiraan jalur lebar tinggi, tetapi ia masih mempunyai kelebihan dari segi kos setiap terabait dan pengembangan kapasiti berskala besar. SSD dan HDD bukan pengganti yang mudah. SSD mengendalikan data panas dan akses berkelajuan tinggi, manakala HDD mengendalikan data jangka panjang dan ekonomi kapasiti.
Menggunakan Senibina Storan untuk Menganalisis Logik Pelaburan: Cara Menilai Susunan Manfaat HBM, DRAM, SSD, dan HDD
Dari perspektif pelaburan, segmen mana yang paling mendapat manfaat—HBM, DRAM, SSD, atau HDD—bergantung pada di mana kesesakan permintaan AI muncul. Jika kesesakan berlaku pada penyampaian data GPU, HBM ialah penerima manfaat yang paling langsung. Jika kesesakan berlaku pada serentakan inferens dan penjadualan sistem, DRAM menjadi lebih penting. Jika kesesakan berlaku pada pemuatan model dan data panas, SSD lebih relevan. Jika kesesakan berlaku pada penyimpanan data jangka panjang dan kos, HDD menjadi lebih kritikal.
| Kesesakan | Produk Lebih Relevan | Jenis Syarikat | Penunjuk Utama |
|---|---|---|---|
| Kesesakan lebar jalur | HBM | Peneraju cip memori | Bahagian HBM, pensijilan, hasil |
| Kesesakan memori sistem | DDR5 / DRAM | Pengeluar DRAM | Harga memori pelayan, peruntukan kapasiti |
| Kesesakan data panas | SSD perusahaan | Syarikat NAND dan SSD | Permintaan SSD perusahaan, harga NAND |
| Kesesakan kos-kapasiti | HDD Nearline | Syarikat HDD | Kontrak pelanggan awan, kapasiti setiap pemacu |
| Kesesakan kecekapan seni bina | Sistem storan berperingkat | Platform storan perusahaan | Perisian, caching, pengurusan data |
Latihan AI dan inferens AI memberi manfaat kepada bahagian stack yang berbeza. Latihan lebih bergantung pada GPU, HBM, bacaan data latihan, dan storan checkpoint. Inferens lebih bergantung pada konkurensi, cache konteks, akses data panas, dan pengekalan log. AI multimodal meningkatkan keperluan storan untuk imej, video, dan audio. Aliran kerja agen dan pangkalan pengetahuan perusahaan meningkatkan keperluan untuk menyimpan data vektor, rekod interaksi, dan konteks jangka panjang. Dari semasa ke semasa, beban kerja inferens yang dinormalisasi mungkin menjadikan permintaan SSD dan HDD lebih stabil, manakala HBM lebih berkait dengan kitaran platform GPU individu dan pensijilan pelanggan.
Kesilapan paling biasa among pelabur ialah mengelompokkan semua "storan AI" ke dalam satu logik yang sama. Syarikat cip memori,.vendor SSD perusahaan, syarikat HDD, dan penyedia sistem storan perusahaan mempunyai leverage pendapatan dan logik penilaian yang berbeza. Anda perlu melihat kedudukan produk, kitaran penetapan harga, perubahan inventori, pengembangan kapasiti, kepekatan pelanggan, dan kos perdagangan secara bersama.
Tunggu — saya perlu membetulkan beberapa perkataan Inggeris yang tersisa: "among" → "dalam kalangan", ".vendor" → "vendor", "leverage" → "leverage" boleh diterima sebagai istilah kewangan. Versi penuh yang betul:
Kesilapan pelabur yang paling biasa ialah mengelompokkan semua "storan AI" ke dalam satu logik yang sama. Syarikat cip memori, vendor SSD perusahaan, syarikat HDD, dan penyedia sistem storan perusahaan mempunyai leverage pendapatan dan logik penilaian yang berbeza. Anda perlu melihat kedudukan produk, kitaran penetapan harga, perubahan inventori, pengembangan kapasiti, kepekatan pelanggan, dan kos perdagangan secara keseluruhan.
Jika anda mengikut nama HBM, DRAM, SSD, dan HDD dalam rantaian bekalan storan pusat data AI, anda perlu menilai bukan sahaja trend industri tetapi juga kos perdagangan sebenar. Kos perdagangan saham A.S. sering merangkumi lebih daripada komisen sahaja. Kos tersebut mungkin juga merangkumi yuran platform, yuran agensi luaran, yuran aktiviti perdagangan, jurang bid-ask, dan kos penukaran mata wang asing. Anda boleh menggunakan data pasaran saham A.S. untuk membandingkan Micron, Western Digital, Seagate, ADR Samsung, atau ETF berkaitan, dan kemudian menyemak yuran perdagangan saham A.S. Biya untuk komisen, yuran platform, yuran agensi luaran, dan kos yang dipaparkan pada pesanan. A.S. milik BiyaKomisi perdagangan saham ialah $0, manakala yuran platform, yuran ejen luaran, dan kos-kos lain tertakluk kepada pendedahan yuran dan halaman pesanan.
Ringkasan: Analisis pelaburan storan AI tidak sepatutnya hanya memfokus pada HBM atau pada "pertumbuhan data" secara umum. HBM sepadan dengan lebar jalur. DRAM sepadan dengan memori sistem dan sokongan inferens. SSD sepadan dengan data panas dan ketahanan berkelajuan tinggi. HDD sepadan dengan ekonomi kapasiti dan penyimpanan jangka panjang. Pendekatan yang lebih berguna adalah untuk pertama sekali mengenal pasti titik tolak pusat data, kemudian memetakannya kepada produk, syarikat, kitaran harga, penilaian, dan kos perdagangan sebenar.
Apabila menganalisis seni bina storan pusat data AI, anda boleh meletakkan HBM, DRAM, SSD, dan HDD pada peta berlapis yang sama dan bukannya mengejar satu titik panas tunggal. Semakin hampir sesuatu lapisan kepada GPU, semakin banyak ia bergantung pada lebar jalur dan latensi. Semakin hampir ia kepada tasik data, semakin banyak ia bergantung pada kapasiti dan kos. Jika anda mahu membandingkan syarikat cip memori, SSD perusahaan, HDD, dan infrastruktur pusat data yang tersenarai di A.S. dan Hong Kong, anda boleh menggunakan Biya untuk melihat aset berkaitan dan menggunakan data pasaran saham Hong Kong untuk menjejak nama semikonduktor dan perkakasan Asia. Anda juga boleh memuat turun Aplikasi Biya untuk menguruskan senarai pantau dan rekod perdagangan.Ketersediaan perkhidmatan bergantung pada lokasi pengguna, hasil pengesahan identiti, peraturan platform, serta undang-undang dan peraturan yang berkuat kuasa. Maklumat pasaran awam, peraturan dagangan, dan struktur yuran adalah untuk rujukan analitikal sahaja dan tidak merupakan nasihat pelaburan.
Soalan Lazim
Mengapakah Pusat Data AI Memerlukan Kedua-dua HBM dan DRAM?
Pusat data AI memerlukan kedua-dua HBM dan DRAM kerana kedua-duanya terletak di tempat yang berbeza dan menjalankan tugas yang berbeza. HBM terutamanya menyokong pengiraan GPU berjalur lebar tinggi, manakala DRAM terutamanya menyokong memori sistem di sisi CPU, penjadualan, prapemprosesan, dan limpahan cache. HBM lebih pantas tetapi lebih mahal, manakala DRAM lebih sesuai untuk kapasiti peringkat sistem dan orkestrasi yang fleksibel.
Adakah Pertumbuhan Inferens AI Meningkatkan Permintaan SSD?
Ya. Pertumbuhan inferens AI boleh meningkatkan permintaan untuk pemuatan model, akses data panas, penulisan log, pengekalan konteks pengguna, dan sebahagian cache berterusan. SSD mengimbangi kelajuan, kapasiti, dan storan tidak meruap, menjadikannya sesuai untuk lapisan data panas. Permintaan sebenar masih bergantung pada seni bina model, keserentakan, dan strategi caching.
Adakah HDD Masih Mempunyai Nilai Pelaburan dalam Pusat Data AI?
HDD mungkin masih mempunyai nilai pelaburan dalam pusat data AI di bawah keadaan yang sesuai. Ia tidak sesuai untuk pengiraan berlebar jalur tinggi atau akses data panas berlatensi rendah, tetapi ia mempunyai kelebihan kos per terabait dalam data mentah, pengarkiban, sandaran, data sejuk, dan storan objek. Perolehan pelanggan awan, kapasiti setiap pemacu, dan margin kasar ialah faktor utama untuk dipantau.
Adakah Pertumbuhan Permintaan HBM Memberi Manfaat kepada Semua Syarikat Memori?
Tidak semestinya. Permintaan HBM terutamanya memberi manfaat kepada syarikat yang mempunyai keupayaan pengeluaran besar-besaran HBM yang maju, perkongsian pembungkusan, kawalan hasil, dan kelayakan pelanggan. Syarikat NAND biasa, HDD, atau memori ceruk mempunyai laluan manfaat yang berbeza dan tidak sepatutnya dikategorikan di bawah logik yang sama. Pelabur harus meneliti gabungan produk dan pendedahan hasil setiap syarikat.
Bagaimana Pelabur Biasa Boleh Mengesan Kitaran Memori AI?
Pelabur biasa boleh menjejaki kemajuan pensijilan HBM, harga DRAM dan NAND, perolehan SSD perusahaan, kapasiti penghantaran HDD nearline, CAPEX penyedia awan, dan margin kasar syarikat memori. Tiada penunjuk tunggal yang cukup untuk menilai kitaran penuh. Lebih baik menggabungkan isyarat harga, inventori, kapasiti, dan penilaian.
Adakah Senibina Storan Pusat Data AI Mempengaruhi Pemilihan ETF?
Ya. ETF yang cenderung kepada HBM dan DRAM lebih sensitif terhadap kitaran harga cip memori, manakala dana yang meliputi syarikat SSD, HDD, atau sistem storan perusahaan mungkin mencerminkan logik kapasiti dan infrastruktur pusat data dengan lebih kuat. Sebelum memilih, pelabur patut menyemak pegangan, nisbah perbelanjaan, pendedahan geografi, kepekatan, dan pendedahan risiko.
*Artikel ini disediakan untuk tujuan maklumat umum dan tidak membentuk nasihat undang-undang, cukai atau nasihat profesional lain daripada BiyaPay atau anak syarikat serta syarikat gabungannya, dan ia tidak bertujuan sebagai pengganti untuk mendapatkan nasihat daripada penasihat kewangan atau mana-mana profesional lain.
Kami tidak membuat sebarang pernyataan atau jaminan, sama ada secara nyata atau tersirat, mengenai ketepatan, kelengkapan atau ketepatan masa kandungan penerbitan ini.
Blog berkaitan

DCA vs. Grid Trading in Crypto: Key Differences, Costs, and Risks


Crypto Off-Ramp Services vs. Exchanges: Fees, Payouts, and Trade-Offs




Pilih Negara atau Wilayah untuk Membaca Blog Tempatan
 Australia
 Austria
 Belgium
 Kanada
 Cyprus
 Republik Czech
 Denmark
 Estonia
 Finland
 Perancis
 Jerman
 Yunani
 Hong Kong
 India
 Indonesia
 Ireland
 Itali
 Jepun
 Latvia
 Lithuania
 Luxembourg
 Malay
 Malta
 Maghribi
 Nepal
 Belanda
 New Zealand
 Norway
 Pakistan
 Filipina
 Poland
 Portugal
 Romania
 Singapura
 Slovakia
 Slovenia
 Afrika Selatan
 Korea Selatan
 Sepanyol
 Sweden
 Thailand
 Amerika Syarikat
 Turki
 Emiriah Arab Bersatu
 United Kingdom
 Vietnam