
Mengapa Memerhati HBM dan Storan Selepas GPU? MENGhurai Rantai Pelaburan Infrastruktur AI




Tema pelaburan infrastruktur AI sedang berkembang daripada "siapa mempunyai GPU" kepada "siapa dapat memastikan GPU beroperasi dengan cekap." Anda tidak sepatutnya hanya melihat kuasa pengkomputeran puncak. Anda juga perlu melihat lebar jalur HBM, kapasiti memori GPU, SSD perusahaan, HDD Nearline, rangkaian, kuasa, dan seni bina storan pusat data. Bagi pelabur biasa, GPU ialah pintu masuk, manakala HBM dan storan ialah isyarat penting untuk menilai sama ada permintaan AI sedang terus merebak merentas rantaian infrastruktur.
Perkara Utama
- GPU menentukan had atas kuasa pengiraan, manakala HBM menentukan throughput model dan kecekapan pergerakan data.
- Latihan AI bergantung pada throughput kluster, manakala inferens AI lebih bergantung pada memori, kependaman, dan keserentakan.
- HBM, DRAM, SSD, dan HDD sepadan dengan tahap suhu data yang berbeza serta kedudukan kos yang berlainan.
- Permintaan storan datanya daripada set data, pangkalan data vektor, log, berat model, dan output inferens.
- Analisis pelaburan perlu memberi tumpuan kepada pesanan, penetapan harga, margin kasar, inventori, dan kepekatan pelanggan.
- Rantai storan AI menawarkan keanjalan pertumbuhan, tetapi turut berdepan risiko pembalikan kitaran dan penguncupan penilaian.
Mengapa HBM dan Storan Datang Selepas GPU?
HBM dan storan menjadi penting selepas GPU kerana kesesakan sistem AI sedang beralih daripada "adakah terdapat GPU yang mencukupi" kepada "adakah GPU dapat menerima data secara berterusan yang cukup pantas, cukup dekat, dan cukup besar." GPU mengendalikan pengiraan, tetapi berat model, data latihan, KV cache, carian vektor, dan log inferens semuanya memerlukan sokongan memori dan storan pada lapisan yang berbeza.
Anda boleh anggap pusat data AI sebagai “kilang AI.” GPU ialah talian pengeluaran utama. HBM ialah gudang bahan berkelajuan tinggi yang dilekatkan pada talian pengeluaran tersebut. DRAM ialah penampan di dalam pelayan. SSD ialah gudang data panas. HDD dan storan objek ialah tasik data berkapasiti besar. Jika gudang itu terlalu kecil atau tali penghantar terlalu perlahan, walaupun GPU yang mahal akan berakhir dengan menunggu data.
Peningkatan produk NVIDIA juga menunjukkan trend ini. 141GB HBM3e dan lebar jalur 4.8TB/s pada NVIDIA H200 menunjukkan bahawa persaingan GPU AI kelas atas bukan hanya tentang Tensor Cores, tetapi juga tentang memori GPU yang lebih besar dan lebar jalur yang lebih tinggi. 1,440GB memori GPU dan lebar jalur HBM3e sebanyak 64TB/s pada DGX B200 membawa trend ini ke peringkat sistem: pelayan AI kini merupakan gabungan GPU, HBM, NVLink, CPU, DRAM, SSD NVMe, dan peralatan rangkaian.
| Segmen | Masalah Utama yang Diselesaikan | Kesan terhadap AI | Aset Perwakilan |
|---|---|---|---|
| GPU | Pengiraan matriks | Menentukan had atas kelajuan latihan dan inferens | Pecut AI |
| HBM | Memori-hampir berkelajuan tinggi | Mempengaruhi throughput model, panjang konteks, dan konkurensi | HBM3E, HBM4 |
| DRAM | Memori sistem | Menyokong CPU, caching, dan prapemprosesan data | DDR5, RDIMM |
| SSD | Akses data-panas | Menyokong pangkalan data vektor, RAG, caching, dan IOPS tinggi | SSD Perusahaan |
| HDD | Penyimpanan kapasiti besar | Menyokong tasik data, sandaran, data latihan, dan log | HDD Nearline |
Bagi pelabur, ini bermakna infrastruktur AI bukan lagi sekadar kisah tentang GPU sahaja. Anda perlu mengikut aliran data: dari mana data itu berasal, bagaimana ia dibaca, bagaimana ia disimpan dalam cache, bagaimana ia memasuki GPU, dan bagaimana keputusan inferens disimpan selepas itu. Jika hanya memandang pesanan GPU sahaja, anda mungkin terlepas perubahan dalam bekalan HBM, harga SSD perusahaan, penghantaran HDD Nearline, dan perbelanjaan modal pusat data.
Seni bina Blackwell dengan 208 bilion transistor dan sambungan cip-ke-cip 10TB/s juga menunjukkan bahawa cip AI sedang memasuki peringkat kejuruteraan sistem. Sambungan dalaman cip, pembungkusan, HBM, memori pelayan, dan rangkaian peringkat rak kesemuanya menentukan kuasa pengiraan yang boleh digunakan, bukannya mana-mana komponen tunggal yang menentukan hasilnya secara bersendirian.
Ringkasan: GPU ialah titik permulaan untuk pelaburan infrastruktur AI, tetapi ia bukan titik akhir. Apa yang benar-benar perlu anda perhatikan ialah sama ada kuasa pengiraan boleh terus dibekalkan dengan data. HBM menyelesaikan isu lebar jalur dan kapasiti berhampiran GPU. DRAM dan SSD menyelesaikan penembolokan di sisi pelayan dan akses data panas. HDD dan storan objek menyelesaikan pengumpulan data berskala besar. Melihat HBM dan storan selepas GPU pada hakikatnya adalah tentang memerhatikan AI bergerak daripada pemerolehan cip kepada pelaksanaan sistem, daripada latihan kepada inferens, dan daripada pembinaan sekali sahaja kepada pengendalian data jangka panjang.
Mengapa HBM Menjadi Bottleneck Utama untuk GPU AI?
HBM telah menjadi penyempitan utama kerana model bersaiz besar bukan sahaja memerlukan pengiraan, malah pergerakan data berkelajuan tinggi. Parameter model, pengaktifan, dan cache KV semuanya perlu bergerak masuk dan keluar dari memori berhampiran GPU dengan kerap. DRAM biasa terletak lebih jauh dari GPU, dan lebar jalur serta latensinya sukar memenuhi keperluan pemecut AI tahap tertinggi. HBM menggunakan penumpukan dan pembungkusan termaju untuk meletakkan memori berlebar jalur tinggi berhampiran GPU.
HBM Menyelesaikan Masalah Lebar Jalur dan Kapasiti Memori Berhampiran
HBM bukan sekadar versi naik taraf bagi modul memori biasa. Ia adalah teknologi memori berjalur lebar tinggi yang direka khusus untuk GPU dan pemecut AI. Melalui die DRAM bertindan, TSV, interposer dan pembungkusan termaju, HBM meletakkan saluran data yang lebih luas lebih dekat dengan unit pengiraan. Matlamatnya bukan sekadar menambah kapasiti, tetapi untuk mengurangkan masa pergerakan data supaya GPU menghabiskan lebih sedikit masa menunggu semasa latihan dan inferens.
HBM3E Micron kubus 8-tinggi 24GB dan lebar jalur melebihi 1.2TB/s mencerminkan nilai teras HBM: setiap tumpukan HBM menyediakan lebar jalur yang sangat tinggi, dan beberapa tumpukan di sekeliling GPU membentuk sistem memori berdurchput tinggi. Dengan Blackwell Ultra, blog teknikal NVIDIA menyebutkan 288GB HBM3e dan 8TB/s lebar jalur setiap GPU, dengan matlamat yang jelas untuk membolehkan model yang lebih besar, tetingkap konteks yang lebih panjang, dan inferens konkurensi yang lebih tinggi berjalan dalam memori berhampiran GPU.
Mengapa HBM Lebih Dekat dengan Rantai Nilai GPU?
HBM ialah lapisan memori yang paling hampir dengan GPU, jadi harganya lebih banyak ditarik secara langsung oleh permintaan pemecut AI. Ia bukan komponen standard yang dijual terutamanya kepada peralatan elektronik pengguna biasa. Sebaliknya, ia berkait rapat dengan GPU AI, pembungkusan termaju, kilang wafer, substrat, pengujian, dan pelan perolehan pembekal awan. Dalam erti kata lain, perubahan dalam permintaan HBM lebih mencerminkan secara langsung kelajuan pembinaan sebenar pelayan AI termaju.
Pada suku ketiga fiskal 2025, Micron menyatakan bahawa hasil HBM meningkat hampir 50% secara berurutan dan hasil pusat data lebih daripada dua kali ganda berbanding tahun lepas. Ini menunjukkan bahawa AI mendorong sebahagian produk kitaran storan ke arah senario pelayan dan pusat data yang lebih bernilai tinggi. SK hynix juga menyatakan bahawa sampel HBM4 12-lapisan telah dihantar kepada pelanggan utama dan persediaan pengeluaran berskala besar akan diteruskan selepas kelayakan, menunjukkan bahawa persaingan HBM telah bergerak daripada HBM3E ke arah HBM4.
Permintaan HBM biasanya meningkat atas lima sebab:
- Kiraan parameter model yang lebih besar memerlukan kapasiti memori-hampir (near-memory) yang lebih tinggi.
- Tetingkap konteks yang lebih panjang meningkatkan penggunaan cache KV dengan pantas.
- Konkuren inferens yang lebih tinggi menjadikan memori GPU sebagai kekangan kapasiti perkhidmatan.
- MoE, RAG, dan AI agentic meningkatkan tekanan akses data.
- Apabila pengiraan GPU meningkat, lebar jalur memori perlu meningkat pada masa yang sama.
Ringkasan: HBM ialah kawasan pertama yang perlu dipantau selepas GPU kerana ia secara langsung menentukan sama ada GPU AI kelas tinggi dapat melepaskan prestasinya. Semakin tinggi puncak pengkomputeran, semakin besar tekanan pergerakan data. Semakin besar model, semakin panjang konteks, dan semakin tinggi konkurensi inferens, semakin kritikal kapasiti dan lebar jalur HBM. Tetapi HBM bukan aset pertumbuhan sehala tanpa risiko. Anda juga perlu memantau kepekatan pelanggan, kapasiti pembungkusan termaju, kadar hasil, penetapan harga kontrak, iterasi teknologi, dan kelajuan pengembangan. Kenaikan HBM datang daripada GPU AI, dan risikonya juga datang daripada kitaran perolehan GPU AI dan pengembangan bekalan.
Jenis Storan Apakah yang Diperlukan untuk Latihan AI dan Inferens AI?
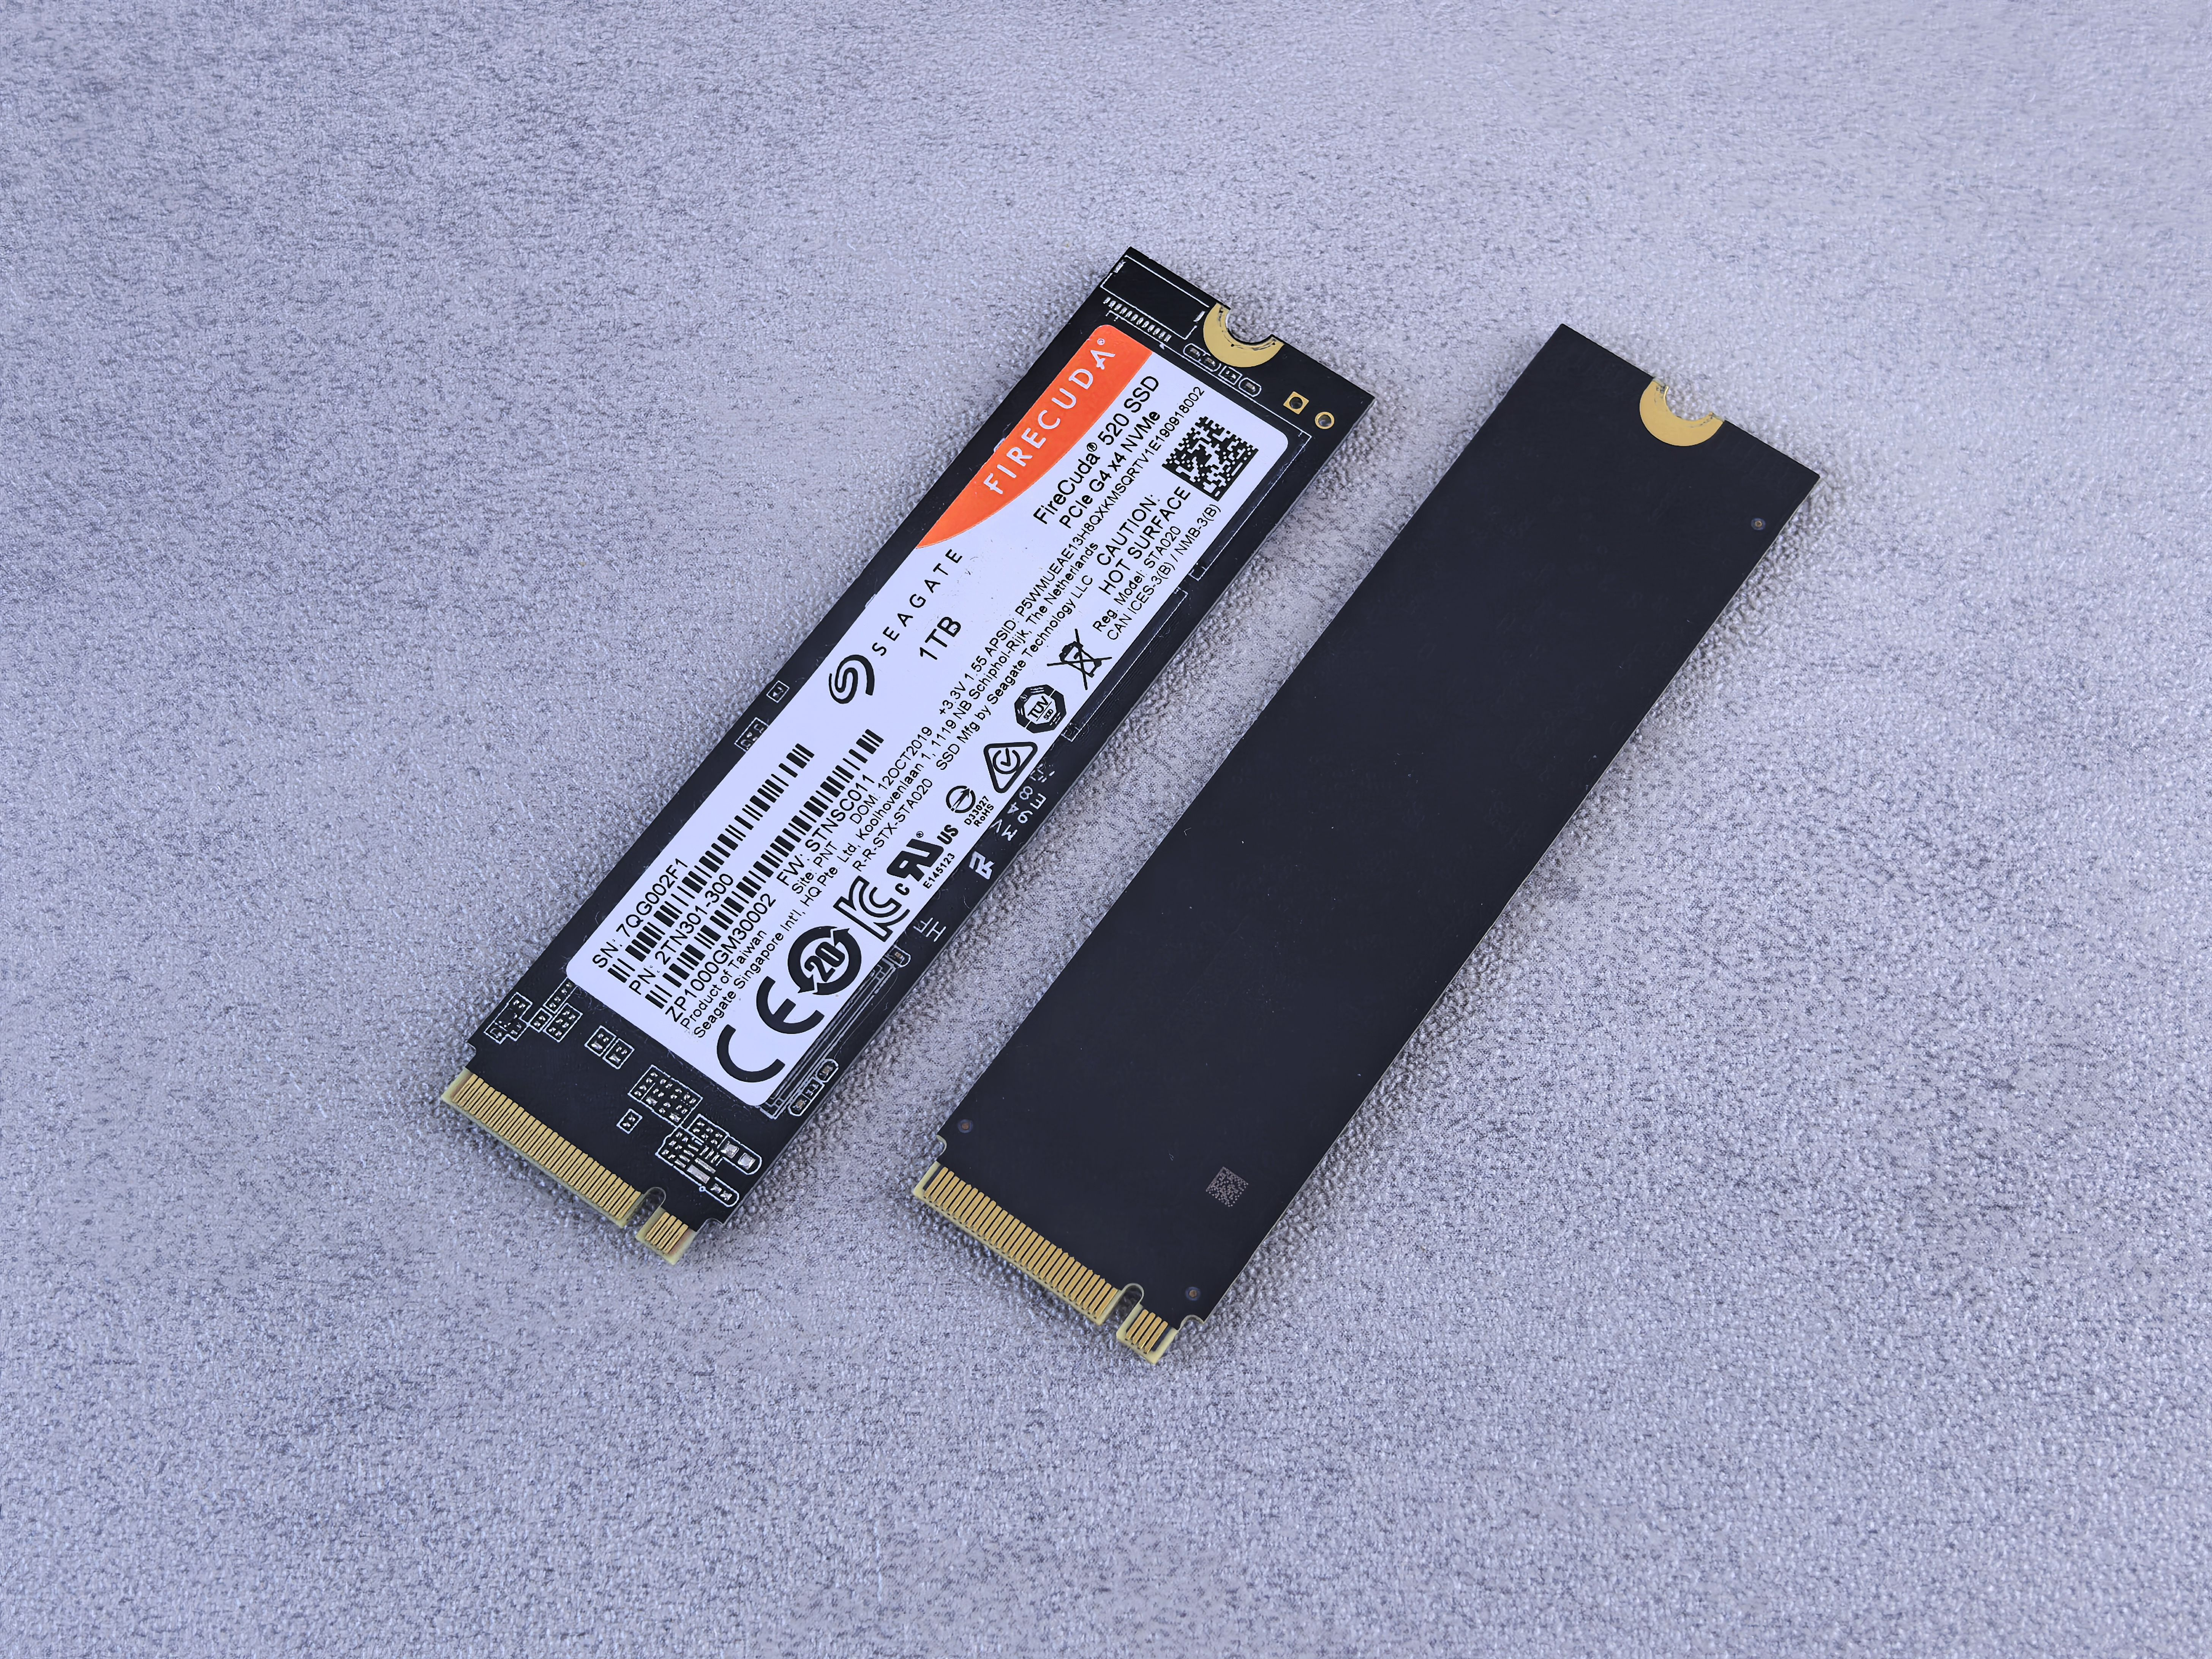
Latihan AI memerlukan throughput tinggi dan kapasiti besar, manakala inferens AI memerlukan latensi rendah, konkurensi, dan akses data panas. Peringkat latihan membaca set data besar secara berterusan, menyimpan checkpoint, dan menghasilkan keputusan perantaraan. Peringkat inferens memproses permintaan pengguna, konteks, KV cache, embeddings, pangkalan data vektor, dan pengambilan dokumen RAG.
Latihan AI Bergantung pada Throughput, Kapasiti, dan Bekalan Data yang Stabil
Latihan tidak berakhir selepas data dimasukkan ke dalam GPU sekali sahaja. Pralatihan memerlukan korpus teks yang besar, data multimodal, dan sistem fail teragih. Penalaan halus memerlukan set data khusus industri dan eksperimen berulang. Semasa latihan model besar, titik semak juga perlu disimpan bagi pemulihan kegagalan dan kembali ke versi terdahulu. Metrik utama di sini bukanlah sama ada satu pemacu pantas, tetapi sama ada keseluruhan sistem storan mampu membekalkan data secara berterusan kepada kelompok GPU.
Keperluan storan biasa dalam latihan termasuk:
| Jenis Data | Kegunaan Utama | Metrik Utama | Storan Berkaitan |
|---|---|---|---|
| Set data mentah | Pralatihan dan pembersihan | Kapasiti, kos, kebolehpercayaan | HDD, storan objek |
| Set data yang dibersihkan | Input latihan | Throughput, kebolehskalaan | SSD, sistem fail teragih |
| Titik semak | Pemulihan kegagalan | Kelajuan tulis, kestabilan | SSD, storan objek |
| Log dan metrik | Pemantauan latihan | Ketekalan, kebolehsanan | HDD, storan objek |
| Keputusan pertengahan | Pengurusan eksperimen | Prestasi baca/tulis, pengurusan versi | SSD, DRAM |
Inferens AI Bergantung pada Latensi Rendah, Konkurensi, dan Data Panas
Sebaik sahaja inferens memasuki penggunaan komersial, tekanan storan beralih daripada "menyediakan data sebelum latihan" kepada "membaca dan menulis data secara berterusan semasa operasi." RAG perlu mendapatkan semula dokumen perusahaan, agen perlu membaca dan menulis hasil alat, model konteks panas menjana sejumlah besar KV cache, dan permintaan serta output pengguna juga menjadi log. Penjelasan WEKA mengenai dinding memori AI merangkumi isu utama: apabila memori yang diperlukan untuk inferens melebihi memori GPU fizikal yang tersedia, kedua-dua latensi dan konkurensi terjejas.
Dalam senario inferens, HBM, DRAM, SSD, dan storan objek membentuk struktur berperingkat. HBM menyimpan data masa jalan model yang paling mendesak. DRAM mengendalikan caching sistem. NVMe SSD menyokong pangkalan data vektor dan data panas. HDD dan storan objek menyimpan data jangka panjang. Apabila anda melihat "lebih banyak aplikasi AI," apa yang sebenarnya berkembang di sebalik tabir ialah token, embeddings, log pengguna, versi model, dan rekod audit semuanya pada masa yang sama.
Ringkasan: Latihan dan inferens mempunyai keperluan storan yang berbeza. Latihan lebih menyerupai projek kejuruteraan berskala besar yang memerlukan bekalan data yang berterusan, berkelajuan tinggi, dan boleh dipulihkan. Inferens pula lebih menyerupai perkhidmatan dalam talian yang memerlukan kependaman rendah, konkurensi tinggi, dan akses data panas. Selepas AI berpindah dari makmal ke persekitaran pengeluaran perusahaan, permintaan storan tidak lagi terhad kepada set data latihan sahaja. Ia meluas kepada pangkalan data vektor, pustaka dokumen RAG, log interaksi pengguna, versi model, rekod audit, dan tasik data jangka panjang. Analisis pelaburan perlu membezakan antara permintaan yang didorong oleh latihan dan permintaan yang didorong oleh inferens, dan bukannya menganggap semua "storan AI" sebagai perkara yang sama.
Dari HBM ke HDD: Bagaimanakah Rantai Storan AI Diketengakan?
Rantai storan AI boleh dilapiskan mengikut "jarak dari GPU." Semakin hampir satu lapisan kepada GPU, semakin banyak ia bergantung pada kelajuan, lebar jalur, dan kependaman. Semakin jauh ia dari GPU, semakin banyak ia bergantung pada kapasiti, kos, dan kebolehpercayaan. HBM ialah segmen bernilai tinggi yang paling hampir dengan GPU. DRAM dan SSD menyokong data panas di dalam pelayan. HDD Nearline dan storan objek menyokong kolam kapasiti pusat data.
Lapisan pertama ialah HBM yang bersebelahan dengan GPU. Ia mengendalikan berat model, pengaktifan, cache KV, dan akses data berfrekuensi tinggi, yang secara langsung mempengaruhi throughput token, panjang konteks, dan inferens serentak. Lapisan kedua ialah DRAM pihak pelayan dan SSD perusahaan, yang mengendalikan caching sistem, prapemprosesan data, pengambilan vektor, dan IOPS tinggi. Lapisan ketiga ialah kolam kapasiti pusat data, di mana HDD Nearline, storan objek, dan sistem sandaran menyimpan data latihan, log, arkib, dan data jangka panjang.
| Lapisan | Jarak dari GPU | Keperluan Kelajuan | Kos Kapasiti Unit | Kegunaan Tipikal |
|---|---|---|---|---|
| HBM | Paling hampir | Tertinggi | Tertinggi | Masa jalan model, cache KV |
| DRAM | Hampir | Tinggi | Tinggi | Cache sistem, pra-pemprosesan |
| Enterprise SSD | Sederhana | Agak tinggi | Sederhana-tinggi | Pangkalan data vektor, data panas, RAG |
| Nearline HDD | Lebih jauh | Lebih rendah | Rendah | Tasik data, sandaran, data latihan |
| Storan objek | Paling jauh | Elastik | Rendah | Arkib, log, pengekalan jangka panjang |
Penggredan ini juga menerangkan mengapa HDD tidak digantikan sepenuhnya oleh SSD. Pusat data AI memerlukan sejumlah besar data panas, tetapi mereka memerlukan data suam dan sejuk yang lebih banyak lagi. Korpus latihan, video, imej, versi model, log, dan sandaran tidak semuanya boleh disimpan dalam HBM atau SSD perusahaan. Pada suku ketiga fiskal 2026, Seagate melaporkan hasil sebanyak $3.112 bilion dan margin kasar GAAP sebanyak 46.5%, menunjukkan bahawa permintaan storan berkapasiti tinggi sedang tersemata-mata dalam keputusan kewangan pembekar cakera keras. Western Digital juga melaporkan hasil sebanyak $3.337 bilion dan margin kasar GAAP sebanyak 50.2% pada suku ketiga tahun fiskal 2026, menunjukkan peningkatan yang jelas dalam kitaran storan awan dan pusat data.
Persoalan utama di sini bukan "sama ada SSD akan menggantikan HDD," tetapi "data manakah yang patut diletakkan di mana." Seiring dengan pertumbuhan data AI, data panas, suam, dan sejuk semuanya bertambah. SSD lebih sesuai untuk akses baca/tulis yang kerap, akses latensi rendah, dan pengambilan vektor. HDD lebih sesuai untuk penyimpanan kapasiti besar pada kos rendah. Dalam kebanyakan kes, kedua-duanya lebih cenderung untuk wujud bersama dalam bentuk berperingkat dan bukannya saling menggantikan secara langsung.
Ringkasan: Peraturan teras rantaian storan AI adalah mudah: semakin hampir data itu dengan GPU, semakin pentingnya kelajuan; semakin jauh ia daripada GPU, semakin pentingnya kapasiti dan kos. Keanjuran pelaburan HBM datang daripada pelepasan prestasi GPU AI. Keanjuran SSD perusahaan datang daripada inferens, RAG, dan akses data panas. Keanjuran HDD Nearline datang daripada tasik data, sandaran, log, dan pengembangan kapasiti penyedia awan. Apabila menganalisis syarikat yang berbeza, anda tidak sepatutnya hanya bertanya sama ada mereka "saham storan AI." Anda juga patut bertanya lapisan storan manakah yang mereka duduki, sebanyak mana hasil mereka bergantung pada penetapan harga, siapa pelanggan mereka, dan adakah bekalan yang terhad itu boleh bertahan.
Penunjuk Apakah yang Perlu Anda Pantau dalam Rantaian Pelaburan Infrastruktur AI?
Untuk menilai rantai infrastruktur AI, anda tidak boleh hanya melihat tajuk berita yang mengatakan "permintaan AI adalah kukuh." Pendekatan yang lebih praktikal ialah memantau tiga kumpulan penunjuk: di sisi permintaan, perbelanjaan modal penyedia awan dan beban kerja AI; di sisi bekalan, kapasiti dan hasil HBM, NAND, dan HDD; di sisi kewangan, pertumbuhan hasil, margin kasar, inventori, aliran tunai, dan kepekatan pelanggan.
Penunjuk permintaan paling penting di sebelah permintaan ialah belanja modal hyperscaler. Sama ada pembekal awan terus mengembangkan pusat data AI menentukan jumlah permintaan untuk GPU, HBM, pelayan, SSD, HDD, dan peralatan rangkaian. Perbelanjaan berkaitan latihan lebih tertumpu pada kluster GPU dan storan throughput tinggi. Perbelanjaan berkaitan inferens lebih menekankan kos, latensi, data panas, dan kecekapan perkhidmatan dalam talian. Anda tidak sepatutnya hanya melihat sama ada sesebuah syarikat berkata "permintaan AI adalah kuat." Anda juga perlu melihat sama ada pesanan bertukar menjadi penghantaran, penetapan harga, dan margin kasar.
Penunjuk sisi bekalan perlu dipisahkan mengikut kategori. HBM terhad oleh dies DRAM, TSV, pembungkusan termaju, hasil pengeluaran, dan kelayakan pelanggan. NAND terjejas oleh kitaran harga dan permintaan SSD perusahaan. HDD memerlukan perhatian kepada HAMR, ketumpatan kawasan, penghantaran exabyte nearline, dan perjanjian bekalan jangka panjang. Pada suku keempat tahun fiskal 2025, hasil Unit Perniagaan Memori Awan Micron sebanyak $4.543 bilion dengan margin kasar 59% menunjukkan bahawa apabila permintaan pusat data AI mengalir ke dalam campuran produk dan harga, keanjalan pendapatan boleh menjadi signifikan.
| Penunjuk | Maksud untuk HBM | Maksud untuk SSD/HDD | Tafsiran Pelaburan |
|---|---|---|---|
| Belanjawan modal (CapEx) pembekal awan | Menentukan kekuatan perolehan GPU/HBM | Menentukan pengembangan kapasiti pusat data | Injap permintaan utama |
| Kontrak HBM | Mengunci harga dan kapasiti | Mempengaruhi bekalan DRAM biasa secara tidak langsung | Isyarat bekalan dan permintaan yang ketat |
| Harga NAND | Mempengaruhi kos SSD secara tidak langsung | Mempengaruhi keuntungan SSD perusahaan secara langsung | Titik perubahan kitaran |
| Penghantaran Nearline | Mencerminkan pertumbuhan data secara tidak langsung | Mempengaruhi hasil vendor HDD secara langsung | Isyarat permintaan kapasiti |
| Margin kasar | Mencerminkan kuasa penetapan harga produk | Mencerminkan penetapan harga dan gabungan produk | Isyarat keanjalan pendapatan |
| Inventori | Membantu menilai ketidaksepadanan bekalan dan permintaan | Membantu menilai kedudukan kitaran | Isyarat risiko |
Terdapat satu dimensi lain yang mudah diabaikan: kos urus niaga. Apabila anda membuat kajian tentang saham infrastruktur AI, selain menilai asas syarikat, anda juga perlu memahami bahawa kos urus niaga sebenar boleh menjejaskan pengalaman pegangan dan pelarasan semula portfolio anda. Kos perdagangan saham AS biasanya merangkumi lebih daripada komisen sahaja. Ia mungkin juga termasuk yuran platform, yuran ejen luaran, yuran aktiviti perdagangan dan caj-caj lain. Biaya mengenakan komisen $0 untuk perdagangan saham AS, manakala yuran platform, yuran ejen luaran dan caj-caj lain tertakluk kepada maklumat yang dipaparkan dalam yuran perdagangan saham AS dan pada halaman pesanan.Sama ada perkhidmatan berkaitan tersedia atau tidak bergantung pada lokasi pengguna, hasil pengesahan identiti, peraturan platform, serta undang-undang dan peraturan yang berkuat kuasa.
Jika anda perlu menjejaki saham A.S. dan Hong Kong merentasi rantaian storan AI, anda boleh menggunakan Biya untuk mengikuti sebut harga pasaran, kelas aset yang tersedia, dan kos akaun. Anda juga boleh menggunakan carian maklumat saham A.S. untuk menyusun nama-nama berkaitan. Yuran bukanlah faktor yang menentukan pulangan pelaburan, tetapi dalam situasi turun naik tinggi, penyeimbangan semula yang kerap, atau pembelian tiket kecil, ia boleh memberi kesan kepada pengalaman perdagangan sebenar.
Ringkasan: Pelaburan dalam infrastruktur AI perlu beralih daripada "pertimbangan konsep" kepada "pengesahan penunjuk." Di sisi permintaan, lihat perbelanjaan modal penyedia awan, penghantaran pelayan AI, serentak inferens, dan penggunaan AI perusahaan. Di sisi bekalan, lihat hasil HBM, pembungkusan termaju, penetapan harga NAND, dan disiplin bekalan HDD. Di sisi kewangan, lihat hasil, margin kasar, inventori, aliran tunai, dan struktur pelanggan. Hanya apabila permintaan benar-benar mengalir ke dalam pesanan, penetapan harga, dan pendapatan, logik pelaburan rantaian storan AI menjadi lebih kukuh.
Apakah Risiko Yang Perlu Anda Perhatikan Semasa Optimistik Terhadap Rantaian Storan AI?
Menjadi bullis terhadap rantaian storan AI tidak bermaksud mengabaikan kitaran dan penilaian. Risiko utama terbahagi kepada tiga kategori: perbelanjaan modal pembekal awan yang lebih perlahan, pengembangan bekalan yang menyebabkan harga storan turun, dan perubahan seni bina teknologi yang mengubah struktur permintaan. Permintaan AI adalah kukuh, tetapi DRAM, NAND, dan HDD masih mempunyai ciri kitaran.
Risiko pertama ialah kelembapan perbelanjaan modal (capex) AI. Jika pembekal awan mendapati hasil inferens, kadar penggunaan komputeran, atau ketersediaan kuasa tidak memenuhi jangkaan, perbelanjaan modal mungkin berkontrak buat sementara waktu. GPU, HBM, pelayan, SSD, dan HDD semuanya sebahagian daripada rantaian belanjawan infrastruktur yang sama, dan kekuatan atau kelemahan permintaan boleh merebak merentasi beberapa segmen. Kekurangan jangka pendek tidak patut dianggap secara langsung sebagai kemakmuran tinggi yang berterusan, terutamanya semasa tempoh penilaian yang tinggi, apabila sebarang perubahan dalam masa pesanan boleh mencetuskan turun naik harga saham.
Risiko kedua ialah pengembangan bekalan. Harga HBM yang tinggal menggalakkan pengilang mengembangkan kapasiti. Harga NAND dan HDD yang lebih tinggi juga meningkatkan kesediaan industri untuk membekalkan lebih banyak. Korea Selatan telah melancarkan pelan pelaburan berskala besar sekitar separa konduktor, HBM, dan pusat data AI. Liputan Reuters tentang pelan pelaburan AI dan cip Korea Selatan menunjukkan kepentingan strategik pada satu pihak, tetapi juga mengingatkan anda untuk memberi perhatian kepada tekanan kitaran masa depan selepas pengembangan bekalan.
Risiko ketiga ialah perubahan laluan teknologi. Pengkuantuman model, kejarangan (sparsity), MoE, kolam memori CXL, pemindahan KV cache, dan pemprosesan hampir-data semuanya boleh mengubah permintaan relatif terhadap HBM, DRAM, SSD, dan HDD. Pengoptimuman perisian boleh meningkatkan penggunaan perkakasan, dan juga boleh mengurangkan permintaan perkakasan setiap unit inferens. SSD dan HDD tidak berada dalam hubungan penggantian yang mudah. Pada masa hadapan, lebih berkemungkinan kedua-duanya akan disusun mengikut suhu data dan kos.
Pelabur patut mengelakkan kesilapan-kesilapan berikut:
- Menganggap semua syarikat penyimpanan sebagai penerima manfaat HBM.
- Hanya melihat pertumbuhan hasil sambil mengabaikan margin kasar dan inventori.
- Hanya melihat latihan AI sambil mengabaikan komersial inferens.
- Mengabaikan penumpuan pelanggan dan penetapan harga kontrak jangka panjang.
- Menganggap kenaikan harga berkala sebagai logik saham pertumbuhan yang kekal.
- Hanya melihat syarikat popular sambil mengabaikan penilaian dan aliran tunai.
Ringkasan: Rantai storan AI menggabungkan logik pertumbuhan dan logik kitaran. Ia bukan sektor sehala berisiko rendah. HBM lebih hampir kepada pertumbuhan GPU AI, tetapi ia juga mempunyai risiko kepekatan pelanggan, kapasiti pembungkusan, dan lelaran teknologi yang lebih besar. SSD dan HDD lebih terjejas oleh kitaran harga, inventori, dan disiplin bekalan. Pendekatan yang lebih berhemat adalah untuk melihat momentum industri, bekalan dan permintaan, penilaian, dan pengesahan kewangan pada masa yang sama. Sebelum berdagang, anda juga perlu memahami peraturan platform, struktur yuran, dan tahap toleransi risiko anda sendiri. Maklumat pasaran awam tidak merupakan nasihat pelaburan.
Jika anda memberi tumpuan kepada pelaburan infrastruktur AI, anda tidak perlu hanya melihat kepada pemimpin GPU. Rangka pemerhatian yang lebih lengkap adalah dengan melihat HBM, DRAM, NAND, SSD perusahaan, HDD Nearline, peralatan pusat data, perbelanjaan modal penyedia awan, dan kos transaksi secara bersama. Anda boleh terlebih dahulu menggunakan logik rantaian industri untuk menapis arah, kemudian menggunakan hasil, margin kasar, inventori, dan aliran tunai untuk mengesahkan kitaran tersebut. Jika perkhidmatan berkaitan tersedia di kawasan anda, anda juga boleh mendaftar akaun untuk meneroka lebih lanjut sokongan perdagangan pelbagai aset Biya. Sama ada perkhidmatan seperti saham A.S., saham Hong Kong, dan aset digital tersedia bergantung pada lokasi pengguna, hasil pengesahan identiti, peraturan platform, serta undang-undang dan peraturan yang berkuat kuasa.Sebarang keputusan perdagangan haruslah berdasarkan matlamat peribadi, toleransi risiko, dan maklumat yuran yang lengkap.
Soalan Lazim
Mengapa Pelabur Infrastruktur AI Tidak Patut Hanya Memandang GPU?
Pelabur infrastruktur AI tidak patut hanya memandang GPU kerana GPU memerlukan HBM, storan, rangkaian, kuasa, dan penyejukan untuk berfungsi dengan cekap. GPU menentukan had atas pengiraan, tetapi HBM menentukan sama ada data boleh memasuki unit pengiraan dengan pantas, manakala SSD dan HDD menentukan sama ada data latihan, pangkalan data vektor, dan log boleh disimpan dan diakses dengan cekap.
Apakah Perbezaan Antara HBM dan DRAM Biasa dalam AI?
HBM terletak lebih dekat dengan GPU dan memberi tumpuan kepada lebar jalur tinggi, latensi rendah, dan pembungkusan berketumpatan tinggi. DRAM biasa terutamanya berfungsi sebagai memori sistem di dalam pelayan. Latihan dan inferens AI melibatkan pergerakan data yang banyak, jadi HBM lebih secara langsung mempengaruhi DAYA MUAT GPU gred tinggi, panjang konteks, dan konkurensi inferens.
Apakah Permintaan Storan yang Didorong oleh Pertumbuhan Inferens AI?
Pertumbuhan inferens AI mendorong permintaan untuk cache KV, pangkalan data vektor, pustaka dokumen RAG, log pengguna, dan akses data panas. HBM dan DRAM mengendalikan near-memory dan cache sistem, SSD perusahaan menyokong pengambilan berlatensi rendah, manakala HDD dan penyimpanan objek mengendalikan penyimpanan data jangka panjang.
Mengapa HDD Nearline Masih Penting untuk Pusat Data AI?
HDD Nearline kekal penting kerana ia menawarkan kelebihan dalam kapasiti besar dan kos penyimpanan seunit yang lebih rendah. Pusat data AI bukan sahaja memerlukan data panas berkelajuan tinggi, malah juga penyimpanan jangka panjang untuk korpus latihan, log, sandaran, arkib, dan versi model. Bagi data sejuk dan suam, HDD kekal sebagai asas kapasiti yang penting.
Bagaimana Pelabur Biasa Boleh Menilai Risiko Saham Penyimpanan AI?
Pelabur biasa harus meneliti permintaan, harga, inventori, margin kasar, kepekatan pelanggan, dan penilaian. Industri penyimpanan sangat berkitaran, dan kenaikan harga jangka pendek tidak sama dengan kepastian jangka panjang. Apabila perdagangan terlibat, peraturan platform, butiran bil, dan keperluan pengawal selia tempatan juga perlu dipertimbangkan.
Adakah Rantai Storan AI Lebih Baik untuk Pelaburan Jangka Panjang atau Perdagangan Kitaran?
Sama ada rantai storan AI sesuai untuk pelaburan jangka panjang bergantung pada kedudukan syarikat dan toleransi risiko peribadi. HBM lebih berkait rapat dengan pertumbuhan GPU AI, manakala SSD dan HDD lebih terjejas oleh kitaran harga. Sebelum membuat sebarang perdagangan, pelabur harus menimbang data kewangan, penilaian, struktur yuran, dan keperluan pematuhan secara bersama.
*Artikel ini disediakan untuk tujuan maklumat umum dan tidak membentuk nasihat undang-undang, cukai atau nasihat profesional lain daripada BiyaPay atau anak syarikat serta syarikat gabungannya, dan ia tidak bertujuan sebagai pengganti untuk mendapatkan nasihat daripada penasihat kewangan atau mana-mana profesional lain.
Kami tidak membuat sebarang pernyataan atau jaminan, sama ada secara nyata atau tersirat, mengenai ketepatan, kelengkapan atau ketepatan masa kandungan penerbitan ini.
Blog berkaitan

US to Portugal Online Money Transfer Limits: Per-Transaction Caps Explained


Cheapest Way to Transfer Money Internationally: Small vs. Large Transfers





Pilih Negara atau Wilayah untuk Membaca Blog Tempatan
 Australia
 Austria
 Belgium
 Kanada
 Cyprus
 Republik Czech
 Denmark
 Estonia
 Finland
 Perancis
 Jerman
 Yunani
 Hong Kong
 India
 Indonesia
 Ireland
 Itali
 Jepun
 Latvia
 Lithuania
 Luxembourg
 Malay
 Malta
 Maghribi
 Nepal
 Belanda
 New Zealand
 Norway
 Pakistan
 Filipina
 Poland
 Portugal
 Romania
 Singapura
 Slovakia
 Slovenia
 Afrika Selatan
 Korea Selatan
 Sepanyol
 Sweden
 Thailand
 Amerika Syarikat
 Turki
 Emiriah Arab Bersatu
 United Kingdom
 Vietnam