
Ano ang HBM? Bakit Umaasa ang Mga AI Server sa High-Bandwidth Memory




Ang HBM ay isang uri ng high-bandwidth memory na patayong nagtutumpak ng maraming layer ng DRAM at pinag-uugnay ang mga ito sa mga GPU, AI ASIC, at iba pang compute chips sa pamamagitan ng isang ultra-wide interface. Ang mga AI server ay nakadepende sa HBM hindi dahil lubos na hindi sapat ang ordinaryong memorya, kundi dahil ang pagsasanay ng malalaking modelo, ang long-context inference, at ang mga serbisyong mataas ang concurrency ay nangangailangan ng mas mataas na memory bandwidth, kapasidad, energy efficiency, at mas maikling distansya ng packaging. Kapag naunawaan mo ang HBM, mas magagawa mong maunawaan ang competitive logic sa likod ng mga kumpanya ng AI chip at memorya tulad ng NVIDIA, AMD, SK hynix, Samsung, at Micron.
Mga Pangunahing Punto
- Ang HBM ay nananatiling isang uri ng DRAM, ngunit gumagamit ito ng 3D stacked architecture.
- Ang mataas na bandwidth ng HBM ay nagmumula sa isang ultra-wide interface at mas maikling distansya ng koneksyon.
- Ginagamit ng mga AI server ang HBM upang mabawasan ang problema sa GPU memory wall.
- Ang kapasidad ng HBM ay nakakaapekto sa laki ng modelo, haba ng context, at concurrency ng inference.
- Kabilang sa mga bottleneck sa pagmamanupaktura ng HBM ang yield, packaging, testing, at thermal control.
- Malamang na magsasama ang HBM3E at HBM4 sa maraming henerasyon ng mga AI platform.
Ano ang HBM, at Paano Iba ang Estruktura Nito mula sa Karaniwang Memorya?
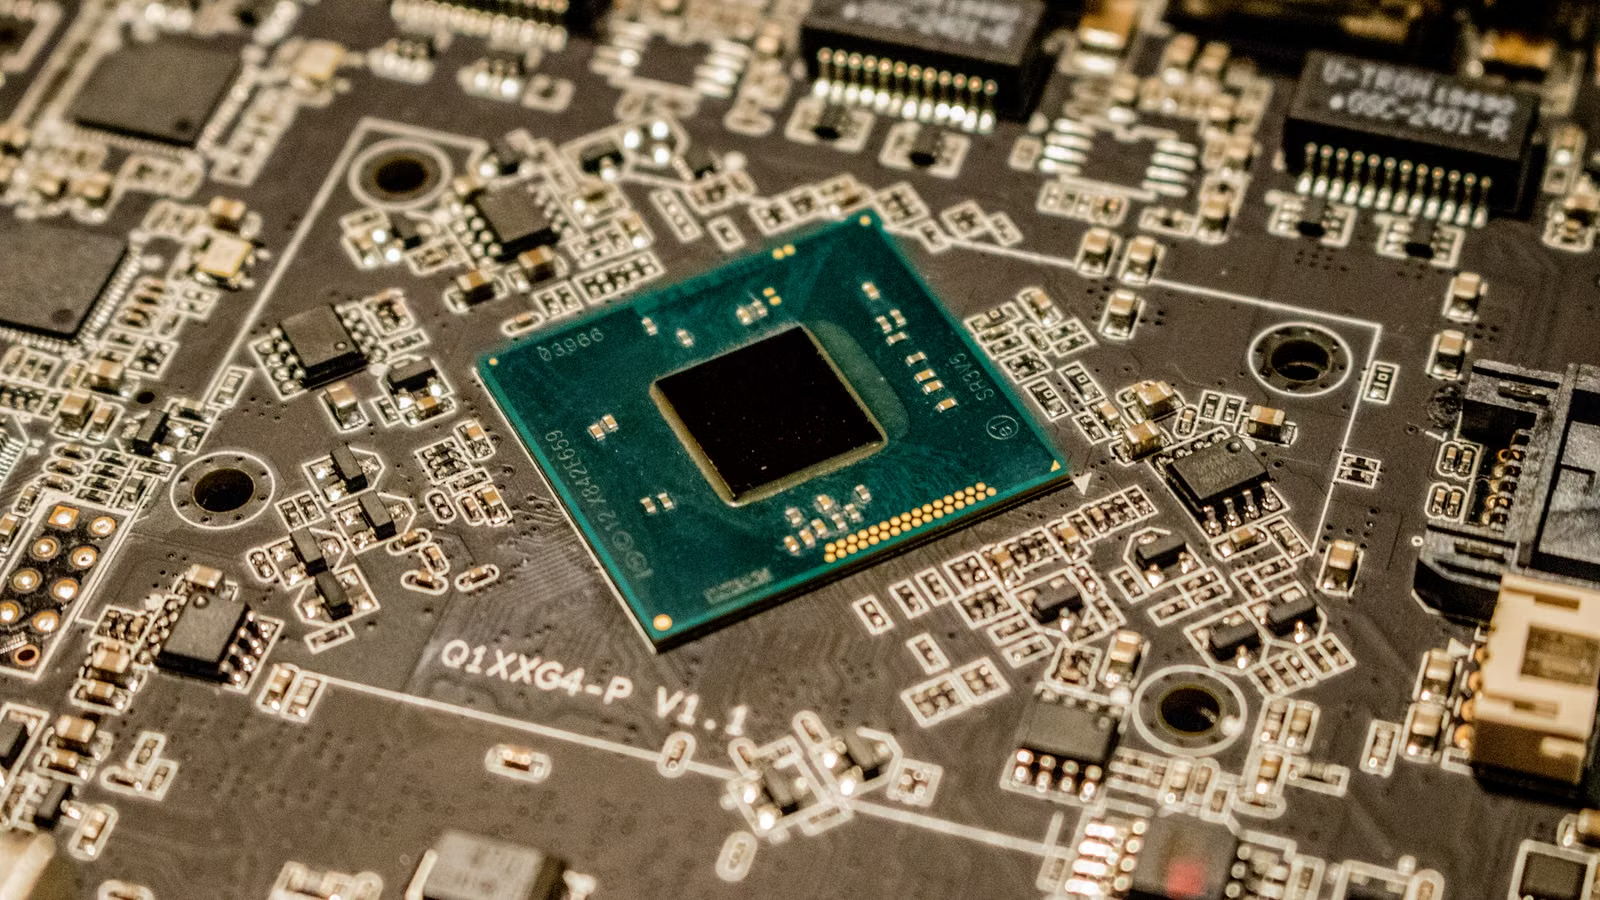
Ang HBM ay nangangahulugang High Bandwidth Memory. Ito ay isa pa ring anyo ng DRAM, ngunit magkaiba ang istruktura nito mula sa karaniwang mga memory module ng server. Ang HBM ay nagsusulat nang patayo ng maramihang DRAM dies, kinokonekta ang mga ito sa pamamagitan ng TSV at iba pang patayong interconnect, at pagkatapos ay inipaketa ang mga ito nang magkasama kasama ang isang GPU o AI accelerator. Ang pangunahing tungkulin nito ay hindi pangmatagalang pag-iimbak ng data, kundi ang mabilis na paghahatid ng mga parameter ng modelo, activations, cache, at mga panggitnang resulta sa panahon ng computation.
Ang karaniwang DDR memory ay karaniwang naka-install sa motherboard ng server at nagsisilbi sa CPU, operating system, mga database, at mga pangkalahatang workload. Ang HBM ay mas malapit sa GPU o AI ASIC, na may mas maikling distansya ng koneksyon at mas malawak na interface. Maituturing mo ang DDR bilang malaking main memory ng server na may malaking kapasidad, habang ang HBM ay ang mabilis na supply layer ng data na malapit sa compute chip. Pareho silang mahalaga, ngunit nagsisilbi sila sa magkaibang posisyon at layunin ng pagganap.
Ang HBM ay binubuo ng maramihang DRAM dies, isang base die, mga TSV, micro bumps, isang interposer, at isang package substrate. Ang mga TSV ay mga patayong channel na dumadaan sa silicon at nag-uugnay ng iba't ibang layer ng DRAM. Ang interposer ay nagbibigay ng mga high-density interconnect sa pagitan ng GPU at HBM. Sa HBM4 standard, pinalawak ng JEDEC ang lapad ng interface sa 2048-bit upang matugunan ang pangangailangan ng AI at HPC para sa mas mataas na bandwidth, mas malaking kapasidad, at mas mahusay na energy efficiency.
| Komponente | Lokasyon | Pangunahing Tungkulin | Epekto sa Pagganap |
|---|---|---|---|
| DRAM Die | Sa loob ng HBM stack | Nag-iimbak ng data habang gumagana | Tumutukoy sa kapasidad at bahagi ng bilis |
| Base Die | Ilalim ng stack | Namamahala sa interface at paglipat ng signal | Nakaaapekto sa kahusayan ng enerhiya at pag-custom |
| TSV | Sa pamamagitan ng silicon | Patayong nag-uugnay ng maramihang layer ng chip | Pinapabuti ang kahusayan ng stacked na paglilipat ng data |
| Micro Bump | Sa pagitan ng mga layer ng chip | Nagbibigay-daan sa tumpak na mga koneksyon | Nakaaapekto sa yield at pagiging maaasahan |
| Interposer | Sa ilalim ng GPU at HBM | Nagbibigay ng high-density na interconnect | Tumutukoy sa sukat ng package at bandwidth |
| Package Substrate | Ilalim ng module | Nag-uugnay sa accelerator module | Nakaaapekto sa paghahatid ng kuryente, signaling, at paglamig |
Hindi nanggagaling sa simpleng pagtataas ng frequency ang "High Bandwidth" sa HBM. Nagmumula ito sa pagpapataas ng kabuuang throughput sa pamamagitan ng mas malalapad na data channels. Madalas na umaasa ang GDDR sa mas mataas na bilis kada pin, habang naglilipat ng data ang HBM sa pamamagitan ng mas maraming parallel channels. Mas angkop ang disenyo na ito sa mga AI accelerator na may mahigpit na mga limitasyon sa power at espasyo, dahil limitado ang laki ng package sa paligid ng GPU at hindi maaaring hindi tiyak na kalatan ang pagkalat ng mga memory chip.
Kailangan ring linawin ang isa pang karaniwang maling akala: ang HBM ay hindi SSD at hindi NAND Flash. Tulad ng ordinaryong DRAM, ang HBM ay volatile memory at hindi nito maisasaulo ang datos kapag nawalan ng kuryente. Hindi rin nito lubos na mapapalitan ang DDR memory sa mga server, dahil ang HBM ay karaniwang naka-package kasama ng GPU, ay mamahalin, magastos ang kapasidad, at hindi madaling palawakin. Mas angkop ito para sa pag-iimbak ng mga datos na may mataas na halaga na kailangan agad ng compute chip.
Buod: Ang HBM ay isang stacked DRAM technology na dinisenyo para sa high-performance computing. Sa pamamagitan ng maramihang DRAM layers, TSVs, isang base die, isang interposer, at advanced packaging, ilalapit nito ang memorya sa GPU at nagbibigay ito ng napakataas na data throughput sa pamamagitan ng isang ultra-wide interface. Ang pagkakaiba ng HBM at ordinaryong DDR ay hindi yaong ang isa ay advanced at ang isa ay obsolete, kundi ang mga ito ay nagsisilbi sa magkakaibang posisyon sa sistema: pinangangasiwaan ng DDR ang pangkalahatang system memory, habang nagbibigay ang HBM ng mataas na bilis na data malapit sa AI accelerator. Kapag naintindihan mo ito, makikita mo kung bakit laging binibigyang-diin sa paglulunsad ng mga AI chip ang kapasidad, bandwidth, at henerasyon ng HBM.
Bakit Nakadepende ang mga AI Server sa HBM?
Nakadepende ang mga AI server sa HBM dahil lumagpas nang malaki ang compute capability ng GPU sa bilis kung paanong pinapakain ng tradisyonal na memorya ang data sa mga compute unit. Kung hindi tuloy-tuloy na pumapasok ang data sa GPU, maraming compute core ang maghihintay sa memorya, na pumipigil sa mga mamahaling AI accelerator na tumakbo nang full load. Madalas tawagin ang bottleneck na ito na "memory wall." Hindi direktagang lumilikha ang HBM ng compute power, ngunit tinutukoy nito kung kayang patuloy na tumanggap ng sapat na data ang mga GPU.
Ang malaking pagsasanay ng modelo ay paulit-ulit na nagbabasa ng mga timbang ng modelo, activations, gradients, at optimizer states. Kapag mas malaki ang modelo, mas marami itong mga parameter at intermediate na data, at mas lumalakas ang kahalagahan nito sa memory bandwidth at kapasidad. Ang inference ay mabigat din, lalo na kapag pinalalawak ng mga long-context na modelo, reasoning na modelo, maramihang pag-uusap (multi-turn), at mga high-concurrency na kahilingan ang KV Cache. Sa pagpapakilala nito sa Blackwell Ultra, binibigyang-diin ng NVIDIA na ang 288GB ng HBM3E ay kritikal para sa mga long-context na modelo na may trilyon-trilyong parameter, at para sa high-concurrency na inference. Ipinapakita nito na ang kompetisyon sa mga AI accelerator ay lumawak na mula sa compute lamang hanggang sa memory system.
Sa panahon ng pagsasanay, ang unang halaga ng HBM ay pagpapabuti ng utilization ng GPU. Magaling ang GPUs sa malakihang parallel computation, ngunit lamang kung tuloy-tuloy ang suplay ng data. Kung kulang ang bandwidth ng HBM, maaaring maghintay ang mga matrix compute unit, at hindi lubos na maisasalin ang theoretical FLOPS sa totoong throughput. Ang pangalawang halaga ay pagbabawas ng model partitioning. Kapag hindi kasya ang isang modelo o training state sa HBM ng isang GPU, kailangan itong hatiin sa maraming GPU, na nagpapataas ng communication, synchronization, at kumplikasyon ng scheduling. Ang pangatlong halaga ay energy efficiency. Ang paggalaw ng mismong data ay kumukonsumo ng malaking power. Dahil malapit ang HBM sa GPU, nito mapapataas ang throughput sa ilalim ng medyo kinokontrol na power consumption.
Laganap na ang kahalagahan ng HBM sa panahon ng inference. Sa mga naunang yugto, maraming nag-akala na ang pagsasanay ay higit na umaasa sa HBM, habang ang inference ay pangunahing isyu ng compute-cost. Pinalitan ng pananaw ang mga long-context at agent application. Ang KV Cache ay lumalaki habang tumataas ang haba ng context, bilang ng sabay-sabay na gumagamit, at haba ng ginagawa, na patuloy na sumasakop sa HBM. Ang NVIDIA H200 ay may 141GB na HBM3E at 4.8TB/s na memory bandwidth; ang AMD Instinct MI325X ay may 256GB na HBM3E at hanggang 6TB/s na peak memory bandwidth. Ipinapakita ng mga naturang detalye na ang mga AI accelerator vendor ay hindi lamang nagdaragdag ng compute, kundi pati na rin ng kapasidad at bandwidth ng memorya.
| AI Workload | Pangunahing Pressure ng Data | Mas Nakadepende sa Bandwidth o Kapasidad | Papel ng HBM |
|---|---|---|---|
| Pretraining ng malaking model | Weights, gradients, activations | Parehong bandwidth at kapasidad | Pinapabuti ang utilization ng GPU |
| Instruction tuning | Model weights, training state | Mas sensitibo sa kapasidad | Binabawasan ang paghahati ng model |
| Real-time inference | Weight reads, KV Cache | Mas sensitibo sa bandwidth | Binabawasan ang latency ng generation |
| Inference na may mahabang context | Large-scale KV Cache | Mas sensitibo sa kapasidad | Naghahawak ng mas mahabang context |
| Serbisyo na maraming sabay-sabay na gumagamit | Multi-user cache at state | Parehong bandwidth at kapasidad | Pinapabuti ang throughput bawat GPU |
| Multimodal models | Mga feature ng imahe, video, at teksto | Parehong bandwidth at kapasidad | Sumusuporta sa masalimuot na daloy ng data |
Ang HBM ay nakakaapekto rin sa kabuuang gastos sa pag-aari ng mga AI server. Kung ang isang GPU ay makapaglalabas lamang ng bahagi ng its performance dahil sa bottleneck ng memorya, kailangang bumili ng cloud providers ng mas maraming GPU para makumpleto ang parehong gawain. Sa kabaliktaran, mas malaking kapasidad ng HBM at mas mataas na bandwidth ay maaaring madagdagan ang throughput ng bawat GPU at pababain ang gastos ng imprastraktura kada token o kada training task. Siyempre, ang mga tunay na gastos ay nakadepende rin sa arkitektura ng modelo, presisyon, estratehiya ng parallelism, mga network interconnect, at software optimization, kaya't hindi dapat ituring ang HBM bilang tanging variable.
Buod: Kailangan ng mga AI server ang HBM dahil ang computation ng malalaking modelo ay lalong pinaghihigpitan ng supply ng data. Ang pagsasanay ay nangangailangan ng bandwidth para mapabuti ang utilization ng GPU at ng kapasidad para mabawasan ang paghahati ng modelo. Ang inference ay nangangailangan ng bandwidth para mabawasan ang latency at ng kapasidad para suportahan ang KV Cache, mahahabang context, at mga sabay-sabay na kahilingan. Kapag kulang ang HBM, maaaring magkaroon ng mababang utilization ang mga GPU, mas mataas na cross-GPU na komunikasyon, mas mahabang inference latency, at mas mataas na unit cost ng serbisyo. Ang HBM ay hindi isang pangalawang spec ng mga AI chip; ito ay isang pangunahing system resource na tumutukoy sa kahusayan ng AI server.
Ano ang Pagkakaiba ng HBM, DDR, at GDDR?
Ang HBM, DDR, at GDDR ay pawang nakabatay sa teknolohiyang DRAM, ngunit nagsisilbi sila sa magkakaibang posisyon at layunin. Nakatuon ang HBM sa sobrang taas na bandwidth at kahusayan sa enerhiya sa loob ng package. Nakatuon ang DDR sa pangkalahatang kapasidad, pamantayan, at scalability. Nakatuon ang GDDR sa mataas na bandwidth sa mga graphics card sa medyo kontroladong gastos. Karaniwang hindi umaasa ang mga AI server sa isang uri lamang ng memorya, kundi pinapayagan ang HBM, DDR, at iba pang mga layer ng storage na magtulungan.
Karaniwang inii-install ang Server DDR5 sa mga memory slot ng motherboard at nagsisilbi sa CPU, operating system, mga database, preprocessing ng data, at mga pangkalahatang computing task. Samantala, ang HBM ay naka-package malapit sa GPU o AI ASIC at nagsisilbi sa data na kasalukuyang pinoproseso ng accelerator. Kahit na ang isang AI server ay naglalaman ng maraming GPU at bawat GPU ay may malaking halaga ng HBM, kailangan pa rin ng server ng system DDR memory para sa mga CPU task, network stack, mga scheduling system, at paghahanda ng data.
Mas karaniwan ang GDDR sa mga consumer GPU, workstation graphics card, at ilang accelerator card. Karaniwan itong inilalagay sa paligid ng GPU sa PCB at nakakamit nito ang mataas na bandwidth sa pamamagitan ng mas mataas na bilis kada pin. Kung ihahambing sa GDDR, may mas malawak na interface, mas mahusay na energy efficiency, at mas maikling packaging ang HBM, ngunit mas mataas din ito sa gastos at kumplikado sa pagmamanupaktura. Dahil dito, karaniwang patuloy na gumagamit ng GDDR ang mga gaming GPU, samantalang mas malamang na gumamit ng HBM ang mga nangungunang AI accelerator.
| Dimensyon ng Paghahambing | HBM | DDR5 | GDDR |
|---|---|---|---|
| Pangunahing Lokasyon | Malapit sa GPU/AI ASIC package | Motherboard ng server | PCB ng graphics card |
| Pangunahing Layunin | Napakalapad na bandwidth at kahusayan sa enerhiya | Pangkalahatang kapasidad at scalability | Bandwidth ng graphics at GPU |
| Katangian ng Interface | Napakalapad, maikling distansya | Standardized na memory channels | Mas mabilis na speed kada-pin |
| Antas ng Gastos | Pinakamataas | Medyo mas mababa | Sa pagitan ng HBM at DDR |
| Kakayahang I-upgrade | Kadalasang naka-fixed pagkatapos ng packaging | Maaaring palawakin sa pamamagitan ng memory modules | Kadalasang naka-fixed sa graphics card |
| Mga Tipikal na Aplikasyon | AI, HPC, data center GPUs | CPU servers, mga database | Gaming GPUs, workstations |
Hindi maaaring ganap na mapalitan ng HBM ang DDR. Ang dahilan ay simple: mahal ang HBM, hindi ito madaling palawakin tulad ng mga DIMM pagkatapos ng packaging, at ang gastos ng kapasidad nito ay hindi angkop para magdala ng buong system memory. Ang malaking dami ng data preprocessing, file caching, CPU inference, mga database, at system scheduling sa mga AI server ay nangangailangan pa rin ng DDR. Mas angkop ang HBM para sa pag-iimbak ng mga mataas na halaga ng data na kasalukuyang kailangan ng GPU, sa halip na ilagay ang lahat ng data sa server sa HBM.
Hindi rin ganap na papalitan ng HBM ang GDDR. Ang mga consumer GPU at maraming aplikasyon sa workstation ay sensitibo sa gastos, at karamihan sa mga gaming, rendering, at magaang na AI workload ay hindi kinakailangang nangangailangan ng bandwidth o gastos sa packaging na kapantay ng HBM. Ang HBM ay nagiging mas makatuwiran lamang kapag sapat na ang mga benepisyo sa performance, energy efficiency, at package density upang ipantay ang gastos. Ang paggamit ng iba't ibang memory solution sa mga linya ng produkto ng AMD, NVIDIA, at iba pang vendor ay sa esensya ay isang trade-off sa pagitan ng performance, gastos, power consumption, at market positioning.
Buod: Ang HBM, DDR, at GDDR ay hindi simpleng nagpapalitan; nagkakaroon sila ng dibisyon ng gawain. Ang DDR ay angkop para sa pangkalahatang memorya ng sistema, ang GDDR ay angkop para sa graphics at mga scenario ng GPU na mas sensitibo sa gastos, at ang HBM ay angkop para sa mga AI at HPC chip na nangangailangan ng pinakamataas na bandwidth, kapasidad, at kahusayan sa enerhiya. Para sa mga AI server, tinutugunan ng HBM ang mabilis na paghahatid ng data malapit sa GPU, tinutugunan ng DDR ang memorya ng sistema para sa buong makina, habang ang mga SSD at HDD ang humahawak sa pag-iimbak ng data sa mas malalayong layer. Ang mahusay na imprastruktura ng AI ay nakasalalay sa magkakaugnay na mga layer ng memorya at storage, at hindi lamang sa pagtatastak ng iisang uri ng memorya.
Paano Ginagawa ang HBM, at Bakit Ito Mahal at Mahirap Palakihin?
Ang HBM ay mahal at mabagal palawakin hindi lamang dahil mamahal ang mga DRAM wafer, kundi dahil nangangailangan ito ng maramihang kilidang kilalang-mabuti na pipisain, uukiran, ipapatong, ididikit, ilalagay sa pakete, susuriin, at pagkatapos ay bibigyang-katibayan nang magkasama sa GPU sa antas ng sistema. Anumang problema sa isang chip layer, koneksyon, o hakbang sa packaging ay maaaring makaapekto sa ani ng buong HBM stack. Ang pagtaas ng kapasidad ng wafer ay hindi nangangahulugan na ang nabebentang HBM ay tataas sa parehong bilis.
Karaniwang nagsisimula ang pagmamanupaktura ng HBM sa mga advanced na DRAM wafer. Unang ginagawa ng mga manufacturer ang mga DRAM die, pagkatapos ay isinasagawa ang wafer thinning at TSV formation, at pagkatapos ay sinasala ang mga die na angkop para sa stacking. Pagkatapos, kailangang maingat na i-align, i-bond, at ikonekta ang maraming die sa base die upang mabuo ang isang kumpletong HBM stack. Kailangan ding i-integrate ang stack na iyon sa GPU, interposer, at package substrate, bago dumaan sa electrical testing, thermal testing, reliability testing, at customer platform qualification.
Kadalasang lumalabas ang CoWoS kasama ang HBM dahil karaniwang nangangailangan ang mga nangungunang AI GPU ng advanced packaging upang mailagay ang GPU at maraming HBM stack sa loob ng iisang module. Ang TSMC CoWoS ay isang 2.5D packaging technology na gumagamit ng interposer upang pagsamahin ang logic chips at HBM, na nagbibigay ng high-density interconnects para sa high-performance computing. Dapat linawin nang malinaw ang mga konsepto: ang HBM ay memorya, ang CoWoS ay isang packaging platform, at ang GPU ay ang compute chip. Sama-sama, binubuo nila ang isang AI accelerator module.
| Hakbang sa Paggawa | Pangunahing Gawain | Karaniwang Bottleneck | Epekto sa Panghuling Produk |
|---|---|---|---|
| DRAM wafer | Gumagawa ng memory chips | Ani ng advanced process | Nakaaapekto sa kapasidad, bilis, at gastos |
| Pagbuo ng TSV | Gumagawa ng patayong mga channel | Karikihan sa etching at pagpuno ng metal | Nakaaapekto sa kalidad ng pinagsamang koneksyon |
| Pag-screen ng die | Pumipili ng kwalipikadong chips | Katumpakan ng pagdetekta ng depekto | Nakaaapekto sa kabuuang ani |
| Stack bonding | Nag-uugnay ng maraming layer ng chip | Alignment, warpage, depekto sa bonding | Tinutukoy ang pagiging maaasahan ng stack |
| Base die | Namamahala ng high-speed interface | Pagpili ng logic design at proseso | Nakaaapekto sa kahusayan ng enerhiya at customization |
| Advanced packaging | Isinasama ang GPU at HBM | Kapasidad ng CoWoS at mga katulad nito | Tinutukoy ang bilis ng pagpapadala |
| Pagsubok at kwalipikasyon | Pinatutunayan ang katatagan | Oras ng pagsubok at pamantayan ng customer | Nakaaapekto sa timing ng mass-production |
| Thermal management | Kinokontrol ang temperatura ng stack | Mas mataas na power density | Nakaaapekto sa performance at haba ng buhay |
Mahirap i-scale ang HBM dahil kumukunsumo ito ng mas maraming manufacturing resources. Maaaring magdala ang isang high-end AI accelerator ng maraming HBM stack, at ang bawat stack ay nangangailangan ng maraming DRAM die. Kumpara sa ordinaryong DRAM, kumukunsumo ang HBM ng mas maraming wafer, packaging, testing, at materyales. Binabatid din sa 2026 memory market outlook ng SK hynix na mananatiling mahalagang direksyon para sa demand ng AI memory ang HBM3E at HBM4, habang ang kakayahang supply ay nakadepende sa kapasidad, yield, at customer validation.
Ang thermal control ay isa pang hamon. Gumagamit ang HBM ng 3D stacked structure, kaya mas mahirap makalabas ang init mula sa mga internal dies. Kapag mas maraming layer ang nakasalansan, mas mataas ang bandwidth, at mas mataas ang power density, mas nagiging mahalaga ang thermal management. Ang paparating na kompetisyon sa HBM ay hindi lamang tungkol sa bandwidth at capacity, kundi pati na rin sa mga materyales, base die design, packaging structure, cooling solutions, at system-level design.
Kung sinusundan mo ang mga kumpanya ng HBM supply chain, hindi mo dapat tingnan lamang ang pamumuno sa teknolohiya, kundi pati rin ang aktwal na gastos sa pangangalakal. Sa mga pampublikong merkado, ang mga kumpanyang nakalista sa US tulad ng Micron, NVIDIA, AMD, Marvell, Seagate, at Western Digital ay may kaugnayan sa AI memory, chips, o data centers. Kapag sinusubaybayan ang mga kaugnay na asset sa pamamagitan ng Biya, dapat mo ring panoorin ang kita ng kumpanya, customer qualification, capital expenditure, at valuation. Naghing ng $0 commission ang Biya sa pangangalakal ng US stock, habang ang mga bayarin sa platform, mga bayarin sa panlabas na institusyon, at iba pang singil ay nakadepende sa US stock trading fees at sa pagpapakita ng order. Ang impormasyon mula sa pampublikong merkado ay hindi bumubuo ng payo sa pamumuhunan.Ang pagkakaroon ng serbisyo ay nakasalalay sa lokasyon ng gumagamit, resulta ng pagpapatunay ng pagkakakilanlan, mga patakaran ng platform, at mga naaangkop na batas at regulasyon.
Buod: Ang kakulangan ng HBM ay nagmumula sa buong supply chain, at hindi sa isang hakbang ng pagmamanupaktura lamang. Nangangailangan ito ng advanced na DRAM, TSV, stacked bonding, base dies, interposers, advanced packaging, pagsubok at kwalipikasyon, at thermal management upang sabay-sabay na mahinog. Ang pagpapalawak ng wafer ay sumosolusyon lamang sa bahagi ng problema. Ang tunay na nagtatakda ng dami ng shipment ay ang yield, kapasidad ng packaging, kwalipikasyon ng customer, at reliability ng sistema. Dahil dito, ang average selling price at margin ng HBM ay karaniwang mas mataas kaysa sa ordinaryong DRAM. Ang mataas nitong presyo ay hindi lamang dahil sa malakas na demand, kundi pati na rin dahil pinag-uugnay nito ang memorya, packaging, at disenyo ng AI accelerator.
Paano Umuunlad ang HBM3E at HBM4, at Sa Ano Ang Magiging Batayan ng Hinaharap na Kompetisyon?
Ang HBM ay lumilipat mula sa HBM3E tungo sa HBM4, ngunit hindi agad magpapalitan ang mga luma at bagong produkto. Mas makatotohanang sitwasyon ay ang HBM3E ay patuloy na maglilingkod sa maraming kasalukuyang AI accelerator, ang HBM4 ay sasabay sa susunod na henerasyon ng GPUs at AI ASICs, at ang HBM4E kasama ang custom HBM ay papasok sa customer validation. Ang paparating na kompetisyon ay hindi lamang tungkol sa kung sino ang may mas maraming kapasidad, kundi kung sino ang makakabalanse ng bandwidth, kapasidad, yield, customer qualification, packaging resources, at disiplina sa capital expenditure.
Ang mga pagpapabuti sa HBM na henerasyon ay pangunahing humahakbang sa apat na direksyon: mas mataas na bandwidth, mas malaking kapasidad, mas mahusay na kahusayan sa enerhiya, at mas matibay na customization. Ipinaliliwanag ng mga materyales ng Micron sa HBM4 na gumagamit ang HBM4 ng 2048-bit interface at idinisenyo upang maghatid ng mas mataas na bandwidth at kapasidad para sa AI at HPC. Nang inanunsyo ng Samsung ang HBM4 commercial shipment, sinabi nito na nakamit ng HBM4 nito ang stable na bilis ng paglilipat na 11.7Gbps at maaari pa itong pahusayin hanggang 13Gbps. Sa HBM4E showcase, binanggit din ng Samsung ang 16Gbps kada pin at 4.0TB/s bandwidth, na nagpapakita na ang susunod na yugto ng kompetisyon ay magpapatuloy sa pag-ikot sa mga bottleneck ng data ng AI accelerator.
| HBM Generation | Pangunahing Direksyon ng Pag-upgrade | Karaniwang Yugto ng Aplikasyon | Susi sa Punto ng Pagmasid |
|---|---|---|---|
| HBM2/2E | Nagtatatag ng stacked high-bandwidth arkitektura | Maagang AI at HPC | Beripikasyon ng teknolohiya at gastos |
| HBM3 | Pinapataas ang kapasidad at bandwidth | Pagsasanay ng Generative AI | Sukat ng pag-aampon ng GPU |
| HBM3E | Mas mataas na bilis at mas malalaking stack | Kasalukuyang pangunahing AI platform | Kwalipikasyon ng customer at kakayahan sa supply |
| HBM4 | 2048-bit na interface, custom base die | Susunod na henerasyon ng AI accelerator | Yield, kahusayan sa enerhiya, at mass production |
| HBM4E/custom HBM | Mas mataas na performance at koordinasyon ng sistema | Susunod na henerasyon ng GPU/ASIC | Co-design at kontrol sa gastos |
Isang mahalagang pagbabago sa HBM4 ay ang paggalaw ng base die mas malapit sa system-level customization. Sa nakaraan, ang HBM ay mas mukhang isang standardized na memory product. Sa hinaharap, maaaring lalong maging isang system component ang HBM na pinagsasamang tinutukoy ng mga GPU vendor, ASIC designer, memory maker, at foundry. Maaaring hingin ng mga customer ang mas malalim na optimization sa interface protocol, power management, laki ng package, signal integrity, thermal path, at paraan ng pag-access ng data. Nagtataas ito ng technical barrier at maaari rin nitong mas mahigpit na iugnay ang mga nangungunang customer sa mga nangungunang HBM supplier.
Upang husgahan ang competitiveness ng mga HBM manufacturer, maaari mong subaybayan ang walong indicator:
- Mass-production timing para sa HBM3E, HBM4, at HBM4E;
- Kwalipikasyon mula sa NVIDIA, AMD, at mga custom ASIC customer;
- Product mix sa 8-Hi, 12-Hi, at mas mataas na stack na mga produkto;
- HBM revenue bilang bahagi ng DRAM business;
- Kung magkakasama bang bumuti ang yield at gross margin;
- Kung sapat ba ang long-term orders para sa bagong kapasidad;
- Kung sapat ba ang CoWoS, substrate, at testing resources;
- Kung maaaring humantong ang capital expenditure sa mga susunod na oversupply.
Para sa mga retail investor, ang HBM ay parehong isyu sa teknolohiya at isyu sa cycle. Sa panig ng demand, panoorin ang AI training, inference, capex ng mga cloud provider, at deployment ng custom ASIC. Sa panig ng supply, panoorin ang mga plano sa pagpapalawak, customer qualifications, at yields ng SK hynix, Samsung, at Micron. Sa panig ng valuation, isaalang-alang kung naipresyo na ba ng merkado ang mga inaasahang mataas na paglago. Para subaybayan ang mga kaugnay na kumpanyang nakalista sa US, maaari mong gamitin ang US stock information search upang tingnan ang pangunahing impormasyon, pagkatapos ay i-cross-check ang mga earnings report, paglulunsad ng produkto, at mga pagbabago sa mga order. Ang mga user na tumutugon sa mga naaangkop na kundisyon ng serbisyo ay maaari ring i-download ang App upang suriin ang mga fee sa order at mga risk disclosure.
Buod: Ang susunod na yugto ng HBM na kompetisyon ay lilipat mula sa purong memorya na mga detalye patungo sa isang labanan sa antas ng sistema sa buong memorya, logic chips, at advanced packaging. Ang HBM3E ay magpapatuloy sa pagsuporta sa maraming umiiral na mga platform, habang ang HBM4 ay nagsisilbi sa susunod na henerasyon ng mga AI accelerator na may mas malawak na interface, mas mataas na bandwidth, at mas malakas na customization. Ang kakayahan ng mga tagagawa na makabuo ng pangmatagalang kita ay nakasalalay sa customer qualification, mass-production yield, mga pingkukuhang packaging, product mix, at disiplina sa capital expenditure. Ang mataas na paglaki ng industriya ay hindi nangangahulugan na ang mga kita o presyo ng mga stock ng mga kaugnay na kumpanya ay tiyak na tataas nang sabay-sabay. Ang mga mamumuhunan ay kailangan pa ring isaalang-alang ang pinakabagong kita, siklo ng supply-demand, at valuation.
Kapag naunawaan mo na ang HBM, nagiging mas malinaw ang AI chip supply chain. Para sa mga accelerator ng NVIDIA at AMD, hindi dapat titingnan lamang ang compute power, kundi pati ang HBM capacity at bandwidth. Para sa SK hynix, Samsung, at Micron, ang kompetisyon ay hindi lamang tungkol sa memory shipments, kundi pati sa customer qualification, yield, at HBM revenue mix. Ang mga advanced packaging player tulad ng TSMC ay maaari ring makaapekto sa final supply pace. Para sa mga retail investor, ang pagsubaybay sa HBM supply chain ay nangangahulugang paglalagay ng technology upgrades, capital expenditure, product qualification, memory pricing, at trading costs sa iisang framework. Ang public market analysis ay dapat sumuporta sa paghuhusga, hindi pumalit sa personal na risk assessment. Ang anumang trade ay dapat batay sa iyong sariling capital plan, mga patakaran ng platform, at mga lokal na regulatory requirement.
FAQ
Ang HBM ba ay DRAM o isang hiwalay na teknolohiya ng memorya?
Ang HBM ay isang uri ng DRAM, ngunit gumagamit ito ng 3D stacking, TSVs, ultra-wide interface, at advanced packaging. Katulad ng DDR ang prinsipyo ng pag-iimbak nito, ngunit magkakaiba ang istraktura ng produkto, paraan ng koneksyon, at mga use case nito. Pangunahin itong naglilingkod sa mga GPU, AI ASIC, at HPC accelerator.
Maaari bang gamitin ng AI server ang HBM lamang nang walang DDR?
Karaniwan ay hindi. Pangunahing naglilingkod ang HBM sa mga GPU o AI accelerator, habang ang DDR ang humahawak sa system memory ng CPU, operating system, preprocessing ng data, mga database, at mga general-purpose na gawain. Kailangan ng mga AI server na magtulungang gumana ang HBM at DDR, sa halip na palitan ng iisang uri ng memorya ang lahat ng antas ng memorya.
Laging mas mabilis bang tumakbo ang mga modelo kapag mas malaki ang kapasidad ng HBM?
Hindi naman sigurado. Ang mas malaking kapasidad ng HBM ay maaaring mag-imbak ng mas malalaking modelo, KV Cache, at mga batch workload, ngunit ang aktwal na bilis ay naaapektuhan rin ng bandwidth ng HBM, compute power ng GPU, arkitektura ng modelo, software optimization, mga pagpipilian sa precision, at komunikasyon ng maraming GPU. Hindi sapat ang kapasidad lamang upang husgahan ang performance.
Maaari bang i-upgrade nang hiwalay ang HBM sa loob ng isang AI server?
Karaniwang hindi. Napakataas ng integration ng HBM sa GPU, interposer, at package substrate, kaya mahirap itong palitan nang hiwalay tulad ng isang memory module pagkatapos umalis ng server sa pabrika. Kapag kailangan ng mas maraming HBM, karaniwang pumapalit ang mga user ng mga accelerator, nagdaragdag ng maraming GPU, o inia-adjust ang mga estratehiya sa model deployment.
Bakit bihirang gumamit ng HBM ang mga consumer GPU?
Ang mga pangunahing dahilan ay ang gastos at kumplikadong packaging. Karamihan sa mga gaming, office, creator, at magagaan na AI workload ay kayang serbisyohan ng GDDR o DDR nang hindi kailangang magbayad sa mataas na gastos ng advanced packaging ng HBM. Mas angkop ang HBM para sa high-end na AI, HPC, at mga data center accelerator.
Ano ang mga pangunahing panganib sa HBM supply chain?
Kasama sa mga pangunahing panganib ang mas mabagal na AI capital expenditure, mga pagkaantala sa customer qualification, mas mahina sa inaasahang yield, kakulangan sa kapasidad ng advanced packaging, mga isyu sa thermal, at sobrang supply pagkatapos ng pagpapalawak. Kapag sinusuri ang mga kaugnay na kumpanya, dapat sumangguni ang mga mamumuhunan sa pinakabagong earnings report, product disclosure, mga patakaran ng platform, at mga lokal na kinakailangan sa regulasyon.
*Ang artikulong ito ay ibinigay para sa pangkalahatang layunin ng impormasyon at hindi bumubuo ng legal, buwis, o iba pang propesyonal na payo mula sa BiyaPay o sa mga subsidiary at kaakibat nito, at hindi ito nilalayong maging kapalit ng pagkuha ng payo mula sa isang financial advisor o sinumang iba pang propesyonal.
Hindi kami gumagawa ng anumang pahayag o garantiya, hayag man o ipinahiwatig, hinggil sa katumpakan, kabuuan, o pagiging napapanahon ng nilalaman ng publikasyong ito.
Mga kaugnay na blog tungkol sa

Chase Wire Transfer Routing Number: Domestic Wires and International SWIFT Codes


DCA vs. Grid Trading in Crypto: Key Differences, Costs, and Risks


Crypto Off-Ramp Services vs. Exchanges: Fees, Payouts, and Trade-Offs

Wire Transfer Requirements: Sender and Beneficiary Details Checklist

Pumili ng Bansa o Rehiyon para Basahin ang Lokal na Blog
 Australia
 Austria
 Belhika
 Canada
 Siprus
 Republika ng Tsek
 Dinamarka
 Estonia
 Pinlandiya
 Pransiya
 Alemanya
 Gresya
 Hong Kong
 India
 Indonesia
 Ireland
 Italya
 Hapon
 Latvia
 Lithuania
 Luxembourg
 Malaysia
 Malta
 Morocco
 Nepal
 Olanda
 New Zealand
 Noruwega
 Pakistan
 Pilipinas
 Poland
 Portugal
 Romania
 Singapore
 Slovakia
 Eslobenya
 Timog Aprika
 Timog Korea
 Espanya
 Suwesya
 Taylandiya
 Estados Unidos
 Turkiya
 Nagkakaisang Arabong Emirato
 Nagkakaisang Kaharian
 Biyetnam