
Ano ang Relasyon sa Pagitan ng HBM at ng mga GPU? Bakit Nakadepende ang mga Shipment ng NVIDIA sa High-Bandwidth Memory




Ang HBM ay hindi ang computing core ng isang GPU. Ito ang high-speed memory na hindi kayang gumana nang episyente ng mga high-end AI GPU nang wala ito. Ang GPU ang gumagawa ng matrix computation, habang ang HBM ay tuloy-tuloy na nagpapakain dito ng model weights, activations, KV cache, at iba pang data. Kung kulang ang memory capacity, hindi kasya ang modelo o context; kung kulang ang bandwidth, kahit ang pinakamalakas na GPU ay magsasayang ng oras sa paghihintay ng data. Ang pag-unawa sa ugnayan ng HBM at mga GPU ay tumutulong sa iyo na hatulan ang tunay na mga limitasyon sa likod ng NVIDIA, mga memory supplier, TSMC advanced packaging, at mga shipment ng AI server.
Mga Pangunahing Punto
- Ang HBM ay high-bandwidth memory, samantalang ang GPU ay isang parallel computing processor.
- Ang performance ng AI GPU ay nakadepende sa compute, memory capacity, bandwidth, at packaging.
- Ang NVIDIA H100, H200, B200, Blackwell Ultra, at Rubin ay patuloy na nagpapataas ng mga HBM specification.
- Ang kakulangan sa HBM, GPU dies, o CoWoS packaging ay maaaring pumigil sa panghuling shipments.
- Pinapabuti ng HBM4 ang bandwidth ngunit dinadagdagan ang mga komplikasyon sa validation, thermal, at supply-chain.
- Ang pamumuhunan sa HBM ay nangangailangan ng pagsubaybay sa mga order, yield, customer qualification, at valuation.
Ano ang Relasyon sa pagitan ng HBM at mga GPU?
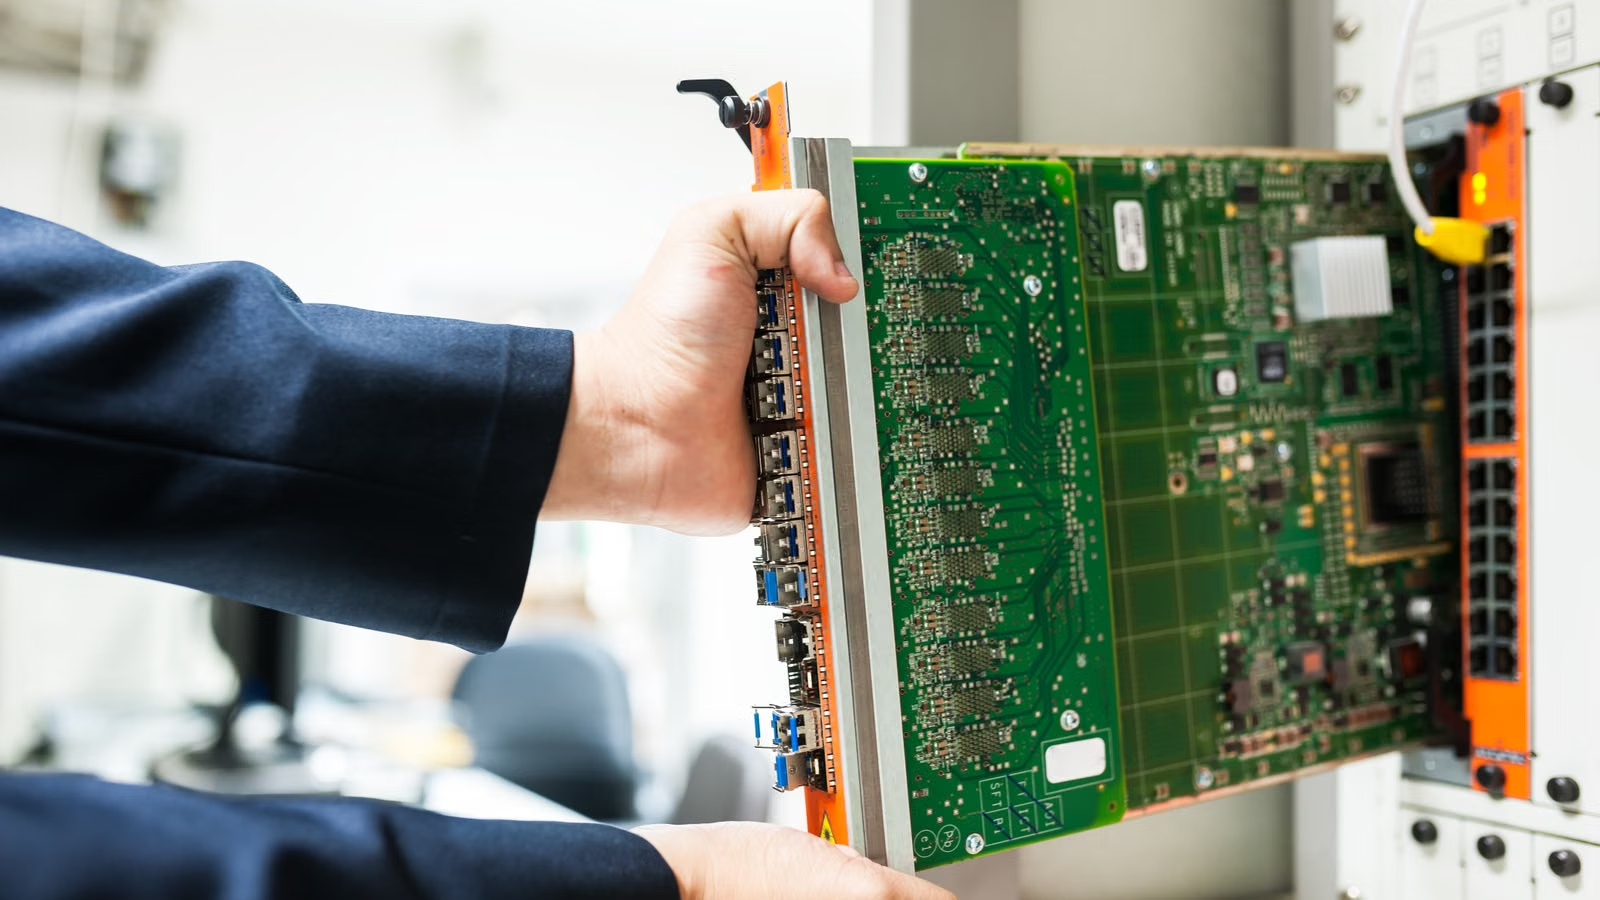
Ang GPU ay ang processor na gumagawa ng computation, habang ang HBM ay ang high-speed memory na nakalagay malapit sa GPU. Maituturing mo ang GPU bilang ang "compute engine" na responsable para sa matrix multiplication, tensor operations, at parallel workloads, habang ang HBM ay ang "high-speed feeding system" na tuloy-tuloy na nagbibigay ng data sa engine na iyon. Sa panahon ng AI training at inference, paulit-ulit na binabasa ng GPU ang model weights, input tokens, activations, intermediate results, at KV cache. Hindi direktang gumagawa ang HBM ng AI computation, ngunit tinutukoy nito kung kayang umabot ang mga data na ito sa GPU nang sapat na bilis.
Sa tradisyonal na kompyuter, ang CPU, memorya, at storage ay karaniwang nakakalat sa iba't ibang bahagi ng motherboard. Sa isang high-end na AI GPU, ang estruktura ay mas compact: ang GPU die at maraming HBM stack ay kadalasang pinag-uugnay sa pamamagitan ng isang interposer at advanced packaging. Ang CoWoS ng TSMC ay isang tipikal na halimbawa. Isinasama nito ang logic chips at HBM stack sa iisang high-density na package, na nagpapahintulot sa GPU na ma-access ang memorya sa pamamagitan ng napakalapad na data channels.
Napakahusay na katangian ng HBM ang stacked structure at ultra-wide interface nito. Hindi ito ordinaryong memorya na inayos bilang iisang patag na chip. Sa halip, maraming DRAM dies ang naka-stack nang patayo, pinag-uugnay sa pamamagitan ng mga TSV, at pinagkokonekta sa GPU memory controller sa pamamagitan ng isang base die at interposer. Kumpara sa karaniwang graphics memory, mas malapit ang HBM sa isang high-bandwidth data pool na inilalagay sa tabi ng GPU.
| Komponent | Pangunahing Tungkulin | Karaniwang Lokasyon | Kahulugan para sa AI GPUs |
|---|---|---|---|
| GPU compute core | Nagsasagawa ng matrix, tensor, at parallel na kalkulasyon | Core ng AI accelerator | Tumutukoy sa teoretikal na compute ceiling |
| HBM | Nag-iimbak ng model weights, activations, KV cache | Malapit sa GPU package | Tumutukoy sa lokal na kapasidad ng memorya at bandwidth |
| CPU DDR memory | Nag-iimbak ng data ng sistema at ilang data ng gawain | Motherboard ng server | Hindi maaaring direktang pumalit sa lokal na memorya ng GPU |
| SSD / storage system | Nag-iimbak ng mga model, dataset, at log nang pangmatagalan | Server o data center | Humahawak sa persistent storage, hindi sa mataas na dalas ng compute access |
Ang estrukturang ito ay nagpapaliwanag din ng isang karaniwang maling akala: ang HBM ay hindi kapalit ng GPU, at hindi rin ito isa pang uri ng compute chip. Sa likas na katangian nito, DRAM pa rin ito, ngunit naka-package at naka-konekta sa paraang mas angkop sa AI GPU. Ang GPU Tensor Cores ang gumagawa ng computation, habang ang HBM ang nagbibigay ng data. Magkakaugnay ang dalawa, ngunit ganap na magkaiba ang kanilang mga tungkulin.
Mula sa pananaw ng software, ang pag-train at inference ng modelo ay hindi lamang basta usapin ng "isang beses na pagbasa ng data." Ang mga Transformer model ay paulit-ulit na nagbabasa ng weights, nagkukwenta ng attention, lumilikha ng activations, at nagpapanatili ng KV cache sa panahon ng inference. Ang paliwanag ng Google Cloud tungkol sa GPU memory ay nagbibigay-diin din na ang kulang na memorya ay tuwirang naglilimita kung paano maaaring i-fine-tune at patakbuhin ang mga modelo. Para sa mga developer, ang kapasidad ng memorya ang nagtatakda kung maaaring patakbuhin ang isang modelo; ang bandwidth ng memorya ang nagtatakda kung gaano ito ka-phys na tumatakbo.
Para sa mga mamumuhunan, mahalaga ang ugnayang ito. Kapag tumitingin sa NVIDIA AI GPUs, hindi sapat na tumuon lamang sa FLOPS, Tensor Cores, o CUDA Cores. Kapag tumitingin sa mga kumpanya ng HBM, hindi rin sapat na ituring ang mga ito bilang ordinaryong DRAM cycle plays. Ang mga high-end AI chip ay naging pinagsamang mga produkto na binubuo ng GPU logic dies, HBM stacks, advanced packaging, at system interconnects. Ang bawat bahagi ay maaaring makaapekto sa panghuling supply.
Buod: Ang relasyon sa pagitan ng HBM at GPU ay maaaring ilarawan bilang koordinasyon sa pagitan ng mataas na bilis na memorya at ang compute core. Ang GPU ay gumagawa ng malakihang parallel computation para sa mga AI model, habang ang HBM ay nagdadala ng model weights, mga pansamantalang resulta, at data ng konteksto sa napakataas na bandwidth. Kung walang GPU, hindi kayang gawin ng HBM ang AI computation nang mag-isa; kung kulang ang HBM, maaaring mapahinga ang mga compute unit ng GPU habang naghihintay ng data. Samakatuwid, upang hukumin ang tunay na kakayahan ng isang AI GPU, kailangang tingnan hindi lamang ang peak compute, kundi pati rin ang kapasidad ng HBM, memory bandwidth, packaging, at system-level interconnects.
Bakit Hindi Kayang Matugunan ng Karaniwang Memorya ang Mga Pangangailangan ng High-End AI GPU
Gumagamit ang mga high-end AI GPU ng HBM hindi dahil walang silbi ang ordinaryong graphics memory, kundi dahil ang training at inference ng malalaking modelo ay nangangailangan ng napakataas na data throughput sa loob ng limitadong power at packaging space. Mabilis na tumataas ang compute capability ng mga GPU. Kung hindi makasabay ang memory bandwidth, maghihintay ang mga compute unit para sa data, at hindi magiging totoong throughput ang teoretikal na compute. Tumutulong ang HBM na maibsan ang problemang “memory wall” sa mga AI accelerator sa pamamagitan ng mas malawak na interface, mas maikling connection paths, at mas mahusay na bandwidth efficiency.
Ang tinatawag na “memory wall” ay nangangahulugang mas mabilis ang pag-improve ng bilis ng compute kaysa sa bilis ng paggalaw ng data. Ang matrix multiplication sa mga AI model ay maaaring mukhang isang compute problem, ngunit bawat computation ay nangangailangan ng pagbasa sa mga weight at input data. Sa inference ng large language model, madalas na kailangan ng decode stage na paulit-ulit na basahin ang mga model weight; kapag mas mahaba ang context, mas malaki ang KV cache. Sa ganitong sitwasyon, ang memory capacity at bandwidth ay direktang nakakaapekto sa bilang ng magkasabay na users, token throughput, at latency.
Ang pagkakaiba ng HBM, GDDR, at DDR ay hindi simpleng “alin ang mas mabilis.” Ang mga ito ay dinisenyo para sa magkakaibang product logic:
| Paghahambing | HBM | GDDR | DDR |
|---|---|---|---|
| Pangunahing aplikasyon | AI GPUs, HPC, mga accelerator sa data center | Mga consumer GPU, gaming GPU, ilang workstation | System memory ng CPU |
| Pinagmulan ng bandwidth | Ultra-wide bus at multi-channel parallelism | Mas mataas na bilis kada pin | General-purpose na memory channels |
| Lokasyon ng packaging | Malapit sa GPU, kadalasang nasa parehong advanced package | Sa palibot ng GPU sa PCB ng graphics card | Motherboard ng server o PC |
| Estruktura ng gastos | Mataas, nakadepende sa advanced packaging at stacking yield | Medyo mas mababa, mas angkop para sa consumer scale | Nakatuon higit sa kapasidad at pangkalahatang gamit |
| Kahusayan sa power | Mas mahusay na efficiency sa mataas na bandwidth | Katamtaman | Hindi angkop bilang direktang lokal na memorya ng GPU |
| Karaniwang limitasyon | Kapasidad, yield, validation, packaging | Bandwidth at power ceiling | Mga limitasyon sa latency at bandwidth |
Gumagamit pa rin ng GDDR ang mga consumer GPU nang malawakan dahil mas sensitibo ang gaming, graphics rendering, at mga produktong pang-masa sa gastos, presyo, at dami ng supply. Kaya ng GDDR na maghatid ng malakas na memory performance nang may mas mababang packaging complexity. Mas angkop ang HBM sa mga data center: mamahalin ang mga indibidwal na GPU, at handa ang mga customer na magbayad ng premium para sa mas mataas na throughput, mas mahusay na power efficiency, at mas malaking model capacity.
Mahalaga rin na paghiwalayin ang "capacity" sa "bandwidth." Sinasagot ng capacity kung kasya ba ang isang bagay; sinasagot ng bandwidth kung gaano ito kabilang basahin. Ang mas malaking memory capacity ay maaaring mag-imbak ng mas malalaking modelo, mas mahahabang context, at mas maraming KV cache. Ang mas mataas na memory bandwidth ay nagbibigay-daan sa GPU na mas mabilis na basahin ang mga datos na iyon. Mahalaga ang pareho, ngunit hindi maaaring magpalitan ang isa't isa.
Ang pagsasanay ng AI ay lubos na nakadepende sa parehong kapasidad at bandwidth. Ang pagsasanay ay nangangailangan ng storage para sa model weights, activations, gradients, at optimizer states. Ang inference ay napapadepende rin nang lalo sa HBM dahil ang mahahabang context, maramihang turn na pag-uusap, retrieval-augmented generation, at mga serbisyong may mataas na concurrency ay lahat nagpapataas ng local memory pressure. Hindi awtomatikong nilulutas ng HBM ang bawat problema sa performance, ngunit ito ay isang mahalagang kondisyon upang mapaabot ng mga high-end AI GPU ang paglampas sa mga memory bottleneck.
| Uri ng Constraint | Pangunahing Sintomas | Kayang Banguhin ng HBM? |
|---|---|---|
| Limitado sa compute | Ang Tensor Cores o matrix compute ang nagiging bottleneck | Sa hindi direktang paraan lamang |
| Limitado sa bandwidth | Naghihintay ang GPU sa mga weights, activations, o KV cache | Malakas na pagbutihin |
| Limitado sa kapasidad | Hindi kasya ang modelo, batch, o context | Malakas na pagbutihin |
| Limitado sa communication | Binabagal ng multi-GPU synchronization at networking ang training | Nangangailangan ng NVLink, InfiniBand, at iba pang interconnects |
| Limitado sa software | Mahina ang kahusayan ng kernel, scheduling, o cache hit rate | Nangangailangan ng optimization ng software stack |
Kaya ang HBM ay hindi lamang isang label na mas mahal at mas advanced. Ito ang resulta ng pag-abot ng AI GPU architecture sa isang yugto kung saan ang paghahatid ng memorya ay nagiging kritikal. Habang tumataas ang compute density, mas malamang na tumama ang mga ordinaryong memory architecture sa mga limitasyon sa packaging area, power consumption, at bandwidth. Gumagamit ang HBM ng mas kumplikadong paraan ng pagmamanupaktura bilang kapalit ng mas malaking kakayahang maglipat ng datos kada unit area.
Buod: Ang karaniwang memorya ay may halaga pa rin, ngunit nahihirapan itong simultaneous na matugunan ang mga high-end na pangangailangan ng AI GPU para sa bandwidth, kahusayan sa power, distansya ng koneksyon, at density ng kapasidad. Ang GDDR ay mas angkop sa cost-sensitive, mabababakas na consumer GPUs, habang ang DDR ay mas angkop bilang CPU system memory. Gumagamit ang mga high-end AI GPU ng HBM dahil pinalalala ng training at inference ang presyon sa paggalaw ng datos: kailangang basahin ang mga model parameter, kailangang isulat ang mga activation, kailangang manatiling lokal ang KV cache, at higit pang pinapataas ng mahabang context at mataas na concurrency ang demand sa memorya. Ang kalamangan ng HBM ay inilalagay nito ang mas maraming datos nang mas malapit sa GPU, inililipat ito nang mas mabilis, at nagbibigay ng mas mababang power consumption kada unit ng bandwidth.
Paano Nakakaapekto ang HBM sa Totoong Pagganap ng Mga NVIDIA AI GPU
Patuloy na pinapataas ng NVIDIA ang kapasidad at bandwidth ng HBM dahil ang bagong idinaragdag na compute ng Tensor Core ay nangangailangan ng sapat na suplay ng data. Ang ebolusyon mula sa H100, H200, B200, at Blackwell Ultra hanggang sa Rubin ay nagpapakita ng malinaw na direksyon: habang tumataas ang kakayahang pang-compute, ang lokal na kapasidad ng memorya at bandwidth ay dapat ding tumaas. Kung hindi, ang AI training at inference ay mapipigilan ng pag-access sa model weights, KV cache, mahahabang context, at sabay-sabay na serving, na magpapigil sa ganap na paggamit ng performance ng hardware.
Ipinapakita ng mga pampublikong detalye na ginaw mas mahalaga ang HBM sa bawat henerasyon ng NVIDIA data center GPU. Ang mga detalye ng NVIDIA H100 SXM ay nagbibigay ng 80GB ng HBM at memory bandwidth na klasing 3.35TB/s. Itinataas ito ng NVIDIA H200 sa 141GB ng HBM3e at bandwidth na 4.8TB/s. Sa henerasyong Blackwell, nagbibigay ang DGX B200 ng 1,440GB na GPU memory at 64TB/s na HBM3e bandwidth sa walong Blackwell GPU, na nangangahulugang humigit-kumulang 180GB at bandwidth na klasing 8TB/s bawat GPU. Kung titingnan nang mas malayo, ang NVIDIA Rubin ay pinaplano na gumamit ng HBM4, na may hanggang 288GB bawat GPU at hanggang 22TB/s kabuuang bandwidth.
| Plataporma | HBM Generation | Pokus sa Memorya at Bandwidth | Kahulugan para sa AI Workloads |
|---|---|---|---|
| H100 | HBM / HBM3-class | 80GB, 3.35TB/s-class | Sinusuportahan ang pangunahing large-model training at inference |
| H200 | HBM3e | 141GB, 4.8TB/s | Pinapabuti ang large-model inference, HPC, at memory-constrained workloads |
| B200 | HBM3e | Ang DGX B200 ay may 1,440GB at 64TB/s sa walong GPU | Sinusuportahan ang demand sa throughput ng Blackwell training at inference |
| Blackwell Ultra | HBM3E | Hanggang 288GB, 8TB/s | Nakatuon sa mas malalaking model, mas mahabang context, at mas mataas na concurrency |
| Rubin | HBM4 | Hanggang 288GB, 22TB/s | Higit pang pinapabuti ang long-context at high-throughput inference |
Ang mga pagbabago sa pagtukoy na ito ay nagpapakita na ang NVIDIA ay hindi lamang basta nagdaragdag ng mas maraming compute. Kumukunsumo ng malaking memorya ang AI training: ang mga model weights, activations, gradients, optimizer states, at distributed training buffers ay lahat gumagamit ng espasyo. Ang mas malaking kapasidad ng HBM ay maaaring mabawasan ang CPU offload, pababain ang presyon ng cross-device partitioning, at payagan ang mas malalaking batch sizes o mas kumplikadong estruktura ng modelo. Ang mas mataas na bandwidth ay tumutulong sa GPU na mabilisang magbasa at magsulat ng data, na nagpapabuti sa utilization ng device.
Ang halaga ng HBM sa inference ay kadalasang binabaliwala. Maraming tao ang nagpapalagay na ang inference ay nangangahulugan lamang ng "patakbuhin ang modelo nang isang beses," ngunit ang long-context inference ay patuloy na nagpapalawak ng KV cache; kapag mas marami ang sabay-sabay na mga user, mas nagiging halata ang lokal na pagkonsumo ng memorya. Ang decode stage ay madalas ding magbasa ng mga weight, at ang kulang na bandwidth ay direktang nakaaapekto sa bilis ng paggawa ng token. Para sa mga cloud provider, ang HBM ay hindi lamang isang specification. Nakaaapekto ito kung ilang request ang kaya ng isang server at kung ilang token ang magagawa kada watt.
Gayunpaman, ang HBM ay hindi isang unibersal na solusyon. Ang totoong performance ay nakasalalay pa rin sa arkitektura ng modelo, quantization, batching strategy, FlashAttention at iba pang kernel optimizations, GPU interconnects, networking, at scheduling systems. Kung ang isang workload ay pangunahing limitado ng network communication, hindi linyar na magpapabuti ang simpleng pagtaas ng HBM bandwidth sa kabuuang bilis. Kung hindi lubos na magagamit ng software ang hardware, maaaring manatili lamang na isang numero sa spec sheet ang peak bandwidth.
Maaari kang gumamit ng tatlong tanong upang husgahan kung gaano nakadepende ang isang AI GPU workload sa HBM:
- Malapit ba ang mga model weights, activations, at KV cache sa limitasyon ng kapasidad ng memorya?
- Paulit-ulit ba na bumabasa ang workload ng malalaking halaga ng weights, na naglilimita sa decode o inference throughput?
- Sa multi-GPU training o inference, ang bottleneck ba ay local memory o cross-GPU communication?
Kung ang sagot ay nakatuturo sa local memory, ang HBM capacity at bandwidth ang mga pangunahing sukatan. Kung ang bottleneck ay nagmumula sa networking, scheduling, o software, mahalaga pa rin ang HBM, ngunit hindi ito ang tanging nagtatakda ng salik.
Buod: Ang mga pagpapabuti ng performance ng NVIDIA AI GPU ay sa esensya mga pagpapabuti sa compute, memorya, interconnects, at software. Ang paglipat mula H100 patungong H200 ay nagpapakita ng halaga ng kapasidad at bandwidth ng HBM3e. Ang B200 at Blackwell Ultra ay nag-uugnay ng mas malaking HBM sa mas malalakas na Tensor Cores. Ang paglipat ng Rubin patungong HBM4 ay dinisenyo upang suportahan ang pangangailangan sa long-context, multimodal, MoE, at high-concurrency inference. Nakakaapekto ang HBM sa totoong performance ng GPU hindi sa pamamagitan ng pagpapalit sa mga compute unit, kundi sa tuloy-tuloy na pagpapakain sa mga ito ng data. Kapag mas malakas ang compute, mas kailangan nito ng mas mabilis, mas malapit, at mas malaking mga memory system.
Bakit Nakadepende ang mga Shipment ng NVIDIA GPU sa HBM
Hindi nagpapadala ang NVIDIA ng hubad na GPU dies sa mga customer. Naghahatid ito ng mga AI accelerator na dumaan na sa HBM matching, advanced packaging, pagbuo ng module, at pagpapatunay ng sistema. Kahit na napagawa na ang mga GPU wafer, maaari pa ring mapaghihigpitan ang dami ng panghuling GPU na ihahatid kung kulang ang mga kwalipikadong HBM stack, kung hindi sapat ang mga yield, kung hindi pa kumpleto ang pagpapatunay ng platform, o kung matalas ang limitasyon sa kapasidad ng CoWoS at iba pang advanced packaging. Kaya't ang pagpapadala ng NVIDIA ay nakadepende sa HBM hindi lamang dahil sa performance, kundi dahil na rin sa istruktura ng pagmamanupaktura at supply chain.
Kadalasang nangangailangan ng maraming hakbang ang isang high-end AI GPU bago mabuo:
- Ang TSMC ang gumagawa ng GPU logic die at pinapabuti ang yield;
- Ang SK hynix, Micron, Samsung, at iba pang supplier ang gumagawa ng HBM;
- Ang HBM ay dumadaan sa DRAM stacking, TSV, base die, testing, at binning;
- Ang GPU die at maraming HBM stack ay pumapasok sa advanced packaging;
- Ang naka-package na produkto ay kumpleto sa reliability, power, thermal, at signal testing;
- Pagkatapos ay binubuo ito sa SXM modules, HGX boards, DGX systems, o buong server.
Sa chain na ito, ang GPU dies, HBM stacks, CoWoS packaging, substrates, thermal systems, at server assembly ay dapat magagamit sa tamang proporsyon. Ang pagpapalawak lamang ng isang bahagi ng chain ay hindi nangangahulugang madadagdagan ang mga panghuling shipment. Kung may sapat na GPU dies ngunit kulang sa HBM, hindi mangyayari ang paghahatid. Kung mayroong HBM ngunit walang CoWoS, hindi mangyayari ang paghahatid. Kahit matapos na ang packaging, ang mga pagkaantala sa server power systems, cooling, o motherboards ay maaari pa ring makaapekto sa mga panghuling iskedyul ng paghahatid.
Ang HBM ay hindi rin isang pamantayang bahaging maaaring palitan nang malaya. Ang mga produktong HBM mula sa iba't ibang supplier ay maaaring magkaiba sa power consumption, bilis, mga katangiang thermal, disenyo ng base die, pagiging komportable ng packaging, at pagiging maaasahan. Maaaring pahintulutan ng NVIDIA ang maraming supplier ng HBM, ngunit bawat produktong HBM ay dapat beripikado para sa isang partikular na platform. Upang makapasok ang isang memory supplier sa supply chain ng NVIDIA, hindi sapat na "kaya nitong gumawa ng HBM." Kailangan nitong patunayan na ang produktong ito ay maaaring gumana nang maaasahan kasama ang target GPU, target package, at target server environment.
| Supply-Chain Link | Pangunahing Kasamang Partisipante | Karaniwang Hadlang | Epekto sa mga Shipment ng NVIDIA |
|---|---|---|---|
| GPU logic chip | TSMC, NVIDIA | Kapasidad ng advanced-node, yield, cycle ng mask | Tinitiyak ang magagamit na dami ng GPU die |
| HBM | SK hynix, Micron, Samsung | Yield ng stacking, kwalipikasyon ng customer, paglalaan ng kapasidad | Tinitiyak ang magagamit na kombinasyon ng memorya |
| Advanced packaging | TSMC at packaging ecosystem | Kapasidad ng CoWoS, interposers, substrates, testing | Tinitiyak kung maaaring pagsamahin ang GPU at HBM |
| System assembly | Mga ODM at vendor ng server | Kapangyarihan, liquid cooling, motherboard, iskedyul ng paghahatid | Tinitiyak ang paghahatid sa antas ng buong server at rack |
| Cloud deployment | Mga hyperscaler at AI cloud provider | Kapangyarihan ng data center, networking, operasyon | Tinitiyak ang bilis ng pagsasakatuparan ng demand |
Ito rin ang dahilan kung bakit pinapanood ng merkado nang sabay-sabay ang HBM, CoWoS, at AI servers. Ang pagtaas ng demand para sa HBM ay nakikinabang sa mga memory supplier tulad ng SK hynix, Micron, at Samsung. Ang demand para sa GPU logic chips ay nakakaapekto sa advanced-node capacity ng TSMC. Ang mas malalaking package at mas maraming HBM stack ay nagdaragdag ng pressure sa CoWoS capacity. Ang mga AI GPU ay lumipat na mula sa single-chip na kompetisyon patungo sa system-level na kompetisyon sa buong memory, foundry, packaging, servers, at data centers.
Para sa mga mamumuhunan, ipinapaliwanag din ng lohikong ito kung bakit nakaaapekto ang balita tungkol sa HBM sa damdamin ng merkado sa NVIDIA supply chain. Kapag nakatanggap ang isang HBM supplier ng key customer qualification, maaaring muling tasahin ng merkado ang mga oportunidad nito sa mga order. Kapag napalawak ang kapasidad ng CoWoS nang mas mabilis kaysa sa inaasahan, maaari ring bumuti ang inaasahan sa mga shipment ng NVIDIA system. Kapag napalawak naman ang kapasidad ng HBM nang masyadong mabilis, kailangan ding bantayan ng mga mamumuhunan ang memory pricing at ang posibleng pagbalik ng inventory cycle.
Kung sinusubaybayan mo ang mga U.S.-listed na pangalan tulad ng NVIDIA, TSMC, at Micron, maaari mong gamitin ang U.S. stock information search upang subaybayan ang data ng mga kaugnay na kumpanya, mga kilos ng merkado, at mga trading signal. Ngunit ang mga balitang may kaugnayan sa HBM ay dapat bigyang-kahululan nang sama-sama ang mga kita, capital expenditure, customer qualification, iskedyul ng pagpapadala, at valuation. Ang isang nag-iisang headline tungkol sa supply chain ay hindi dapat ituring na isang deterministikong konklusyon sa pamumuhunan.
Buod: Ang mga pagpapadala ng NVIDIA GPU ay nakadepende sa HBM dahil sa dalawang dahilan. Una, kailangan ng mga AI GPU ang HBM upang magbigay ng lokal na memorya na may malaking kapasidad at mataas na bandwidth, o kung hindi ay hindi maaaring tuloy-tuloy na tumanggap ng data ang mga compute unit. Pangalawa, sa huli ay nagbebenta ang NVIDIA ng kumpletong AI accelerator at mga sistema, at hindi mga hiwalay na GPU die. Ang bawat high-end GPU ay nangangailangan ng maraming kwalipikadong HBM stack, advanced packaging, pagsubok ng module, at pagbuo ng server. Kapag sinusuri ang supply ng NVIDIA, kailangan mong tingnan ang mga GPU die, HBM stack, capacity ng CoWoS, substrate, cooling, kuryente, at cloud deployment nang magkasama, at hindi lamang isang bilang ng produksyon ng chip.
Kung Paano Maaaring Magbago ng HBM4 ang Pagsusuri sa Pagganap ng GPU at Supply-Chain
papahusayin pa ng HBM4 ang lokal na bandwidth ng memorya at density ng kapasidad para sa mga AI GPU, ngunit hindi nito gagawing mas simple ang supply chain. Sa halip, mas higit pang magkakabit-bit ang HBM4 ng mga GPU, memory supplier, base die, advanced packaging, at system cooling. Maaari mong isipin ang HBM4 bilang isang pangunahing direksyon ng upgrade para sa susunod na henerasyon ng mga AI GPU: makapagpapagaan ito ng mga memory bottleneck sa long-context inference, high-concurrency serving, at deployment ng malalaking modelo, ngunit madadagdagan din nito ang kumplikasyon ng validation, yield, gastos, at packaging.
Mula sa isang pananaw sa mga pamantayan, isa sa mga pinakamahalagang pagbabago ng HBM4 ay ang mas malawak na interface. Ang JESD270-4 HBM4 standard ay sumusuporta sa isang 2048-bit na interface at bilis ng paglilipat na hanggang 8Gb/s, na nagbibigay-daan sa hanggang 2TB/s ng bandwidth bawat stack. Kumpara sa HBM3E, ang HBM4 ay hindi lamang nagtataas ng frequency; dinadagdagan nito ang sabayang paglilipat ng data sa pamamagitan ng mas malawak na interface at mas maraming channel.
Ang mga memory supplier ay nagpapatung-patungan na sa paligid ng HBM4. Ang Samsung HBM4 ay nagtatampok ng 2048 I/O at hanggang 3,300GB/s bandwidth. Ang Micron HBM4 ay nagtutukoy ng 2048-pin na bus interface, bilis na lampas 11.0Gbps, at mahigit 2.8TB/s kada stack. Ang SK hynix HBM4 ay binibigyang-diin ang mas mataas na bandwidth at kahusayan para sa mga customer ng susunod na henerasyong AI. Ipinapakita ng mga senyales na ito na naging pangunahing larangan ng labanan ang HBM4 para sa mga memory supplier na lumalaban para sa AI platform qualification at mga premium order.
Ngunit ang HBM4 ay nagdadala rin ng mas malaking kahirapan. Ang mas malapad na interface at mas mataas na bandwidth ay nangangahulugang ang signal integrity, power, thermal management, at packaging space ay nagiging mas mahirap kontrolin. Ang base die ay nagiging mas mahalaga rin dahil hindi na ito basta ang pinakailalim lamang na layer ng memory stack; maaari rin itong magdala ng mas kumplikadong interface, logic, at mga custom na function. Sa hinaharap, ang mga HBM supplier at GPU maker ay kailangang magsimula ng joint design nang mas maaga, at ang mga customer qualification cycle ay maaaring maging mas mahalaga pa.
Maaaring pagbutihin ng HBM4 ang:
- Lokal na memory bandwidth ng GPU;
- Ang laki ng model at context na kayang suportahan ng isang GPU;
- Token throughput sa ilang inference scenario;
- Headroom para sa long-context at mataas na concurrency na mga serbisyo;
- Presyon sa energy efficiency para sa ilang data-transfer na gawain.
Hindi masosolusyunan ng HBM4 nang mag-isa ang mga sumusunod:
- Mga bottleneck sa networking ng multi-GPU o multi-node;
- Mga limitasyon sa power, liquid cooling, at rack deployment ng data center;
- Mga isyu sa software scheduling, kernel optimization, at cache hit-rate;
- Ang computational complexity ng mga arkitektura ng AI model;
- Mataas na gastos ng HBM at potensyal na panganib ng oversupply.
Mula sa pananaw ng pagsusuri sa industriya, ang panahon ng HBM4 ay nangangailangan ng pagsubaybay kung tunay na inaampon ang isang produkto, at hindi lamang kung may inihayag ang isang supplier nito. Kahit na parehong nag-aalok ng HBM4 ang dalawang supplier, maaaring magkaiba nang lubos ang mga resulta depende sa kung ang kanilang mga produkto ay pumasa sa qualification sa NVIDIA, AMD, o mga customer ng custom ASIC; kung pumapasok sila sa mass production; kung matatag ang yield; at kung tugma sila sa target na package. Magkakaiba ang kahulugan ng mga plano sa kapasidad, pagpapadala ng mga sample, customer qualification, pangmatagalang kasunduan sa supply, at kinikilalang kita.
Kung itatrato mo ang HBM bilang isang trading theme, dapat mo ring bigyang-pansin ang aktwal na gastos sa transaksyon. Ang mga gastos sa pag-trade ng U.S. stock ay hindi lamang tungkol sa komisyon; maaari ring kabilang dito ang platform fees, external agency fees, transaction activity fees, at iba pang singil. Nag-charge ang Biya ng $0 komisyon sa pag-trade ng U.S. stock, habang ang platform fees, external agency fees, at iba pang gastos ay napapailalim sa U.S. stock trading fees at sa order page. Ang availability ng serbisyo ay nakadepende sa lokasyon ng gumagamit, resulta ng beripikasyon ng identidad, mga patakaran ng platform, at naaangkop na mga batas at regulasyon. Ang impormasyon sa publikong merkado, mga patakaran sa pag-trade, at istruktura ng bayad ay hindi bumubuo ng payo sa pamumuhunan.
Buod: Itutulak ng HBM4 ang mga AI GPU memory system tungo sa mas mataas na bandwidth at mas malaking kapasidad, ngunit magpapakumpliko rin ito ng pagsusuri sa supply chain. Hindi lamang dapat tingnan ang "mas mataas ang bandwidth ng HBM4." Kailangan din nating subaybayan ang base dies, packaging, thermal management, customer qualification, yield, at timing ng mass production. Para sa NVIDIA, nakakatulong ang HBM4 sa mga paparating na platform tulad ng Rubin na suportahan ang long-context inference at high-throughput training. Para sa mga memory supplier, ang HBM4 ay isang oportunidad na mapabuti ang product mix. Para sa mga mamumuhunan, kinakatawan ng HBM4 ang isang growth theme at mga potensyal na panganib mula sa capacity expansion, price volatility, at sobrang taas ng mga inaasahan.
Paano Subaybayan ang HBM at GPU Supply Chain Mula sa Pananaw ng Pamumuhunan
Para masuri ang HBM at GPU supply chain, hindi sapat na sabihing “Malakas ang NVIDIA” o “Kulang ang HBM.” Mas epektibong paraan ay hatiin ang chain sa anim na layer: demand, mga specification, capacity, qualification, pricing, at financial realization. Ang paglaki ng NVIDIA GPU shipments ay magtataas ng HBM demand, ngunit ang kita at tubo ng mga memory supplier ay nakasalalay pa rin sa product generation, customer mix, contract pricing, yield, capital expenditure, at ang tradisyonal na DRAM cycle.
Maaari kang magtuon sa mga sumusunod na indicator:
| Dimensyon | Tiyak na Senyalo | Pangunahing Tanong |
|---|---|---|
| Mga detalye ng GPU platform | Bilang ng HBM stack bawat GPU, kapasidad, bandwidth | Nagdaragdag ba ang bagong platform ng nilalamang HBM? |
| Kwalipikasyon ng customer | Kapumapasok ba ng HBM ang NVIDIA, AMD, o ASIC customer validation | Nakapasok na ba ang supplier sa isang core platform? |
| Pagpapalawak ng kapasidad | HBM wafer starts, packaging, TSV, kapasidad sa testing | Mas mabilis ba ang pagpapalawak kaysa sa demand? |
| Advanced packaging | CoWoS, interposer, substrate, kapasidad sa testing | Binabagalan ba ng packaging ang panghuling paghahatid ng GPU? |
| Realisasyon sa pananalapi | Humingi ng bahagi ng kita mula sa HBM, gross margin, prepayment, imbentaryo | Nagiging tubo ba ang mga order? |
| Panig ng demand | Cloud capex, deployment ng AI server, kita mula sa inference | Bumibili pa ba ang mga downstream customer? |
Madalang magkamali nang dalawang labis na paghuhusga ang mga tema ng HBM. Ang una ay ang pagtingin lamang sa demand habang hindi isinasaalang-alang ang supply. Ang malakas na demand sa AI GPU ay hindi nangangahulugang palaging magkakaroon ng kakulangan sa HBM. Kapag agresibong pinapalawak ng mga memory supplier ang kanilang kapasidad, ang presyo at imbentaryo ay maaaring bumalik sa cyclical volatility. Ang ikalawa ay ang pagtingin lamang sa mga memory supplier habang hindi isinasaalang-alang ang packaging at mga sistema. Kahit na tumaas ang supply ng HBM, hindi tiyak na tataas din sa parehong bilis ang paghahatid ng NVIDIA GPU kung hindi makasunod ang CoWoS, substrates, liquid cooling, kuryente, o server assembly.
Kailangan ding makilala ng mga mamumuhunan ang teknikal na pamumuno mula sa benepisyong pananalapi. Ang pagiging una sa pag-anunsyo ng HBM4 ay hindi nangangahulugang agad agad na makabubuo ang isang kumpanya ng malakihang kita. Ang pagpasa sa kwalipikasyon ng customer ay hindi tiyak na nangangahulugang magsisimula agad ang mataas na margin na dami ng produksyon. Ang pagpasok sa supply chain ay hindi awtomatikong nangangahulugang makatwiran ang valuation. Para sa mga kumpanya ng HBM, ang mas mahahalagang tanong ay ang bahagi ng high-end na HBM sa kabuuang kita, ang kontribusyon sa margin, ang pangmatagalang kasunduan sa supply, ang disiplina sa kapital, at kung nakakadagdag ba ng pabigat ang mga tradisyonal na cycle ng DRAM/NAND.
Kung sinusubaybayan mo ang NVIDIA, TSMC, Micron, mga ADR na kaugnay ng SK hynix, o iba pang pangalan sa AI supply-chain sa mga merkado ng U.S. at Hong Kong, maaari mong gamitin ang Biya upang makita ang multi-asset market data at trading access. Para sa mga gumagamit na nakakatugon sa mga kaugnay na kundisyon ng serbisyo, magagamit din ang Biya App upang sundan ang mga pagbabago sa U.S. stocks, Hong Kong stocks, at digital asset market. Bago mag-trade, dapat mo pa ring tingnan ang mga fee sa order page, mga lokal na kinakailangan sa regulasyon, risk tolerance, at pagiging karapat-dapat ng account.
Ang isang mas disiplinadong framework ng pagsubaybay ay ang ituring ang HBM bilang isang "midstream amplifier" ng compute demand. Kapag patuloy na pinapataas ng mga cloud provider ang AI capex, pinapataas ng mga bagong platform ng NVIDIA ang HBM content, sabay na lumalawak ang CoWoS, pumapasa sa qualification ang mga memory supplier, at nananatili ang price discipline, mas malamang na ma-convert ang HBM theme sa mga financial result. Sa kabaligtaran, kung bumagal ang downstream capex, sabay-sabay na napapakawala ang kapasidad, bumababa ang presyo, o tumataas ang inventory, maaaring bumalik ang HBM mula sa isang growth story patungo sa isang memory-cycle story.
Buod: Ang lohika ng pamumuhunan sa HBM at GPU ay hindi simpleng "Malakas ang NVIDIA, kaya malakas din ang lahat ng kumpanya ng HBM." Ang mas kumpletong pananaw ay dapat kasama ang mga detalye ng GPU platform, dami ng HBM, kwalipikasyon ng customer, advanced packaging, capex ng cloud, presyo ng memorya, at halaga ng kumpanya. Ang HBM ay isang mahalagang bottleneck sa supply ng AI GPU at isang mahalagang variable sa pagbabago ng industriya ng memorya mula sa tradisyonal na cycles tungo sa mataas na antas na mix ng mga AI product. Ngunit ang bawat tema ng supply-chain ay dumadaan sa expectations, orders, kita, tubo, at muling pagtatakda ng halaga. Bago magkalakal, dapat pag-isipang magkasama ang pampublikong impormasyon, datos sa pananalapi, at mga hangganan ng panganib.
Kapag naintindihan mo na ang relasyon sa pagitan ng HBM at mga GPU, nagiging mas madali ang paghihiwalay ng iba't ibang driver ng kita sa buong supply chain ng AI chip. Pangunahing nakikinabang ang NVIDIA mula sa mga GPU platform at sa software ecosystem nito. Nakikinabang ang TSMC mula sa mga advanced node at CoWoS. Nakikinabang ang mga memory supplier mula sa mga upgrade ng HBM product-mix. Ang mga server vendor at cloud provider naman ang sumasalin sa mga pagbabago sa deployment at capex. Kapag sinusubaybayan mo ang mga kaugnay na U.S. at Hong Kong stocks sa pamamagitan ng Biya, maaari mong ikumpara ang mga galaw ng presyo, earnings, shipment schedules, istraktura ng bayarin, at valuation sa loob ng isang framework. Naniningil ang Biya ng $0 komisyon sa pangangalakal ng U.S. stocks, habang ang mga platform fee, external agency fee, at iba pang gastos ay nakadepende sa fee center at order page.Popular na AI supply-chain na mga stock ay maaaring maging pabago-bago, kaya't dapat mong maunawaan ang mga uri ng order, estruktura ng bayad, mga pundasyon ng kumpanya, at ang iyong sariling antas ng pagpapakalantis sa panganib bago mag-trade.
Mga Madalas Itanong
Bahagi Ba ng GPU ang HBM o Isang Malayang Chip?
Ang HBM ay isang malayang ginawang DRAM stack, ngunit sa mga high-end AI GPU ito ay karaniwang isinasama sa GPU die sa loob ng parehong advanced package. Hindi ito ang GPU compute core, ngunit ito ay mahalagang local memory para sa buong AI accelerator. Sa simpleng pagpapaliwanag, ito ay isang malayang chip sa pagmamanupaktura, ngunit bahagi ng GPU module sa antas ng sistema.
Bakit Karaniwang Gumagamit ang mga Gaming GPU ng GDDR sa Halip na HBM?
Kadalasang gumagamit ng GDDR ang mga gaming GPU dahil mas mababa ang gastos at mas simple ang packaging nito, kaya't mas angkop ito para sa mga consumer product na maraming volume. Ang HBM ay nagbibigay ng mas mataas na bandwidth at mas mahusay na efficiency, ngunit mas mataas din ang gastos sa pagmamanupaktura, qualification, at advanced packaging nito, kaya't pangunahing ginagamit ito sa data center AI, HPC, at mga high-end professional accelerator.
Laging Mas Malakas Ba ang Performance ng GPU Kapag Mas Malaki ang HBM Capacity?
Hindi laging ang mas malaking kapasidad ng HBM ay nangangahulugan ng mas malakas na performance ng GPU. Ang mas maraming kapasidad ay maaaring mag-imbak ng mas malalaking modelo, mas malalaking batch, at mas malaking KV cache, ngunit ang aktwal na bilis ay nakadepende rin sa memory bandwidth, compute capability, software optimization, arkitektura ng modelo, GPU interconnects, at configuration ng server. Tinutukoy ng kapasidad kung kayaang magkasya ang isang workload; tinutukoy naman ng bandwidth at compute kung gaano ito kabilis tumakbo.
Maaari Bang Kumuha ang NVIDIA ng HBM Mula sa Maraming Supplier Nang Sabay-Sabay?
Maaaring kumuha ang NVIDIA ng HBM mula sa maraming supplier, ngunit ang produkto ng bawat supplier ay dapat pumasa muna sa pagpapatunay ng performance, power, reliability, at packaging compatibility para sa isang partikular na GPU platform. Ang pagdaragdag ng mga supplier ay maaaring mapalawak ang supply at mabawasan ang panganib ng single-source, ngunit hindi maaaring simpleng ipalit ang hindi kwalipikadong HBM sa isang production platform.
Bakit Nakapagpapaliban ang Kakulangan sa HBM ng Paghahatid ng NVIDIA GPU?
Maaaring maantala ang paghahatid ng NVIDIA GPU dahil sa kakulangan sa HBM dahil ang bawat maibebentang AI GPU ay nangangailangan ng maraming kwalipikadong HBM stack, na susundan ng advanced packaging at pagsubok sa sistema. Kahit na napagawa na ang mga GPU die, maaari pa ring maantala ang panghuling paghahatid dahil sa kakulangan sa HBM, CoWoS, substrate, o pagbuo ng server.
Paano Maaaring Hatulan ng mga Retail Investor Kung Sobrang Supply ang HBM Supply Chain?
Dapat mongitoring ng mga retail investor ang HBM capacity expansion, customer qualification, average selling prices, inventory, delivery lead times, cloud capex, at GPU shipment volume nang magkakasama. Hindi sapat ang mga capacity plan ng supplier lamang. Ang susi ay kung maisasalin ba ng mga order ang kita at tubo. Ang mga partikular na paghuhusga ay dapat ibatay sa mga earnings report, mga paghayag ng kumpanya, at mga regulatory filing.
*Ang artikulong ito ay ibinigay para sa pangkalahatang layunin ng impormasyon at hindi bumubuo ng legal, buwis, o iba pang propesyonal na payo mula sa BiyaPay o sa mga subsidiary at kaakibat nito, at hindi ito nilalayong maging kapalit ng pagkuha ng payo mula sa isang financial advisor o sinumang iba pang propesyonal.
Hindi kami gumagawa ng anumang pahayag o garantiya, hayag man o ipinahiwatig, hinggil sa katumpakan, kabuuan, o pagiging napapanahon ng nilalaman ng publikasyong ito.
Mga kaugnay na blog tungkol sa

Wire Transfer Requirements: Sender and Beneficiary Details Checklist


Crypto-Related Stocks vs Digital Assets: What Investors Actually Own




Pumili ng Bansa o Rehiyon para Basahin ang Lokal na Blog
 Australia
 Austria
 Belhika
 Canada
 Siprus
 Republika ng Tsek
 Dinamarka
 Estonia
 Pinlandiya
 Pransiya
 Alemanya
 Gresya
 Hong Kong
 India
 Indonesia
 Ireland
 Italya
 Hapon
 Latvia
 Lithuania
 Luxembourg
 Malaysia
 Malta
 Morocco
 Nepal
 Olanda
 New Zealand
 Noruwega
 Pakistan
 Pilipinas
 Poland
 Portugal
 Romania
 Singapore
 Slovakia
 Eslobenya
 Timog Aprika
 Timog Korea
 Espanya
 Suwesya
 Taylandiya
 Estados Unidos
 Turkiya
 Nagkakaisang Arabong Emirato
 Nagkakaisang Kaharian
 Biyetnam