
Bakit Titingnan ang HMB at Storage Pagkatapos ng mga GPU? Pagsira-sira sa Investment Chain ng AI Infrastructure




Ang tema ng pamumuhunan sa AI infrastructure ay lumalawak mula sa "sino ang may mga GPU" patungo sa "sino ang makapagpapanatiling gumagana nang episyente ang mga GPU." Hindi dapat titingnan lamang ang peak computing power. Kailangan mo ring tingnan ang HBM bandwidth, GPU memory capacity, enterprise SSDs, Nearline HDDs, networking, kuryente, at data center storage architecture. Para sa mga karaniwang mamumuhunan, ang mga GPU ang entry point, samantalang ang HBM at storage ay mahahalagang senyales para hukuman kung patuloy na kumakalat ang demand sa AI sa buong infrastructure chain.
Mga Pangunahing Punto
- Ang mga GPU ang nagtatakda ng itaas na hangganan ng compute, habang ang HBM ang nagtatakda ng throughput ng modelo at kahusayan ng paglipat ng datos.
- Ang AI training ay nakadepende sa throughput ng cluster, habang ang AI inference ay mas nakasalalay sa memorya, latency, at concurrency.
- Ang HBM, DRAM, SSD, at HDD ay tumutugma sa iba't ibang temperatura ng datos at posisyon ng gastos.
- Ang demand sa storage ay nagmumula sa mga dataset, vector database, log, model weights, at mga output ng inference.
- Ang pagsusuri sa pamumuhunan ay dapat magtuon sa mga order, presyo, gross margin, imbentaryo, at konsentrasyon ng mga customer.
- Ang AI storage chain ay nag-aalok ng growth elasticity, ngunit kinahaharap din nito ang mga panganib ng pag-ikot ng cycle at pag-compress ng valuation.
Bakit Kasunod ng mga GPU ang HBM at Storage?
Nagiging mahalaga ang HBM at storage pagkatapos ng mga GPU dahil ang bottleneck ng AI system ay lumilihis mula sa "may sapat bang GPU" patungo sa "kaya bang tuloy-tuloy na tumanggap ng datos ang mga GPU na sapat kabilis, sapat kalapit, at sapat kalaki." Pinangangasiwaan ng mga GPU ang computation, ngunit ang model weights, training data, KV cache, vector search, at inference logs ay lahat nangangailangan ng iba't ibang antas ng suporta mula sa memorya at storage.
Isipin mo ang isang AI data center bilang isang “AI factory.” Ang mga GPU ang pangunahing production line. Ang HBM ang mataas na bilis na bodega ng mga materyales na nakakabit sa production line na iyon. Ang DRAM ang buffer sa loob ng server. Ang mga SSD ang bodega ng mainit na datos. Ang mga HDD at object storage ang malaking data lake na may malaking kapasidad. Kung masyadong maliit ang bodega o masyadong mabagal ang conveyor belt, kahit ang mga mamahaling GPU ay maghihintay din sa datos.
Ang mga pag-upgrade ng produkto ng NVIDIA ay nagpapakita rin ng trend na ito. Ang 141GB na HBM3e at 4.8TB/s na bandwidth ng NVIDIA H200 ay nagpapakita na ang kompetisyon sa high-end AI GPU ay hindi lamang tungkol sa mga Tensor Core, kundi pati na rin sa mas malaking GPU memory at mas mataas na bandwidth. Ang 1,440GB na GPU memory at 64TB/s na HBM3e bandwidth ng DGX B200 ay itinutulak ang trend na ito sa antas ng sistema: ang isang AI server ay isa nang pinagsama-sama ng mga GPU, HBM, NVLink, CPUs, DRAM, NVMe SSDs, at mga kagamitan sa networking.
| Segemento | Pangunahing Suliraning Nilulutas | Epekto sa AI | Kinatawang Asset |
|---|---|---|---|
| GPU | Kalkulasyon ng matrix | Tinutukoy ang itaas na hangganan ng bilis ng pagsasanay at inference | AI accelerator |
| HBM | Mabilis na near-memory | Nakaaapekto sa throughput ng modelo, haba ng context, at concurrency | HBM3E, HBM4 |
| DRAM | Memorya ng sistema | Sumusuporta sa CPU, caching, at preprocessing ng datos | DDR5, RDIMM |
| SSD | Pag-access sa hot-data | Sumusuporta sa vector database, RAG, caching, at mataas na IOPS | Enterprise SSD |
| HDD | Malaking kapasidad ng imbakan | Sumusuporta sa data lake, backup, datos ng pagsasanay, at log | Nearline HDD |
Para sa mga investor, nangangahulugan ito na ang AI infrastructure ay hindi na isang solong kwento tungkol sa GPU. Kailangan mong sundan ang daloy ng datos: saan nagmumula ang datos, kung paano ito binabasa, kung paano ito naka-cache, kung paano ito pumapasok sa GPU, at kung paano iniimbak ang mga resulta ng inference pagkatapos. Ang pagtingin lamang sa mga order ng GPU ay maaaring magdulot na hindi mo mapansin ang mga pagbabago sa supply ng HBM, sa presyo ng enterprise SSD, sa mga shipment ng Nearline HDD, at sa capital expenditure ng data center.
Ang 208 bilyong transistor ng Blackwell architecture at 10TB/s na chip-to-chip interconnect ay nagpapakita rin na ang mga AI chip ay papasok na sa yugto ng system engineering. Ang mga internal chip interconnect, packaging, HBM, server memory, at rack-level networking ay sama-samang nagtatakda ng magagamit na compute power, sa halip na ang anumang isang bahagi lamang ang magpasya nang mag-isa sa kalalabasan.
Buod: Ang mga GPU ang pasukan sa pamumuhunan sa imprastruktura ng AI, ngunit hindi sila ang dulo ng lahat. Ang tunay na kailangan mong obserbahan ay kung nagagatungan nang tuloy-tuloy ng data ang compute. Tinutugunan ng HBM ang mga isyu sa bandwidth at kapasidad malapit sa GPU. Tinutugunan ng DRAM at SSD ang server-side caching at pag-access sa hot data. Tinutugunan ng HDD at object storage ang malawakang pag-ipon ng data. Ang pagtingin sa HBM at storage pagkatapos ng mga GPU ay sa esensya ay pagsubaybay kung paano lumilipat ang AI mula sa pagbili ng chips patungo sa pag-deploy ng sistema, mula sa training patungo sa inference, at mula sa isang beses na konstruksyon patungo sa pangmatagalang pagpapatakbo ng data.
Bakit Naging Pangunahing Bottleneck ang HBM para sa mga AI GPU?
Ang HBM ay naging pangunahing bottleneck dahil ang malalaking modelo ay hindi lamang nangangailangan ng computation, kundi pati na rin ng mabilis na paglipat ng data. Ang mga parameter ng modelo, activations, at KV cache ay lahat ay kailangang regular na ipasok at ilabas sa memorya na katabi ng GPU. Ang karaniwang DRAM ay mas malayo sa GPU, at ang bandwidth at latency nito ay nahirapang makasabay sa pangangailangan ng mga nangungunang AI accelerator. Gumagamit ang HBM ng stacking at advanced packaging upang ilagay ang high-bandwidth memorya malapit sa GPU.
Tinutugunan ng HBM ang mga Problema sa Bandwidth at Kapasidad ng Memorya na Malapit sa GPU
Hindi lamang isang na-upgrade na bersyon ng isang karaniwang memory module ang HBM. Ito ay isang high-bandwidth memory technology na dinisenyo nang nakabatay sa mga GPU at AI accelerator. Sa pamamagitan ng stacked DRAM dies, TSVs, interposers, at advanced packaging, inilalapit ng HBM ang mas malalapad na data channel sa compute unit. Ang layunin ay hindi lamang simpleng pagtaas ng kapasidad, kundi ang pagpapabilis ng paglipat ng data upang mas kaunti ang oras ng paghihintay ng mga GPU sa panahon ng training at inference.
Nagbibigay ang 24GB 8-high cube ng Micron HBM3E at mahigit 1.2TB/s ng bandwidth ng pangunahing halaga ng HBM: nagbibigay ang bawat HBM stack ng napakataas na bandwidth, at ang maraming stack sa paligid ng GPU ay bumubuo ng isang memory system na may mataas na throughput. Sa Blackwell Ultra, binanggit ng technical blog ng NVIDIA ang 288GB ng HBM3e at 8TB/s ng bandwidth kada GPU, na may malinaw na layuning payagan ang mas malalaking modelo, mas mahahabang context window, at mas mataas na concurrency ng inference na tumakbo sa loob ng memorya na katabi ng GPU.
Bakit Mas Malapit ang HBM sa Value Chain ng GPU?
Ang HBM ang pinakamalapit na layer ng memorya sa GPU, kaya ang presyo nito ay mas direktang hinihila ng demand para sa AI accelerator. Ito ay hindi isang standard na komponent na pangunahing ibinebenta sa mga karaniwang consumer electronics. Sa halip, ito ay mahigpit na nakaugnay sa AI GPUs, advanced packaging, wafer foundries, substrates, testing, at mga plano sa procurement ng mga cloud provider. Sa madaling salita, ang mga pagbabago sa demand ng HBM ay mas direktang nagpapakita ng totoong bilis ng pagtatayo ng mga high-end AI server.
Sa ikatlong kuwarto ng fiscal 2025, binanggit ng Micron na halos 50% ang paglaki ng kita ng HBM sequentially at higit sa dalawang beses ang paglaki ng kita ng data center year over year. Ipinapakita nito na itinutulak ng AI ang ilang storage-cycle product tungo sa mas mataas na halaga ng server at data center na mga senaryo. Sinabi rin ng SK hynix na naipadala na ang mga sample ng 12-layer HBM4 sa mga pangunahing customer at na ipagpapatuloy ang paghahanda sa mass production pagkatapos ng qualification, na nagpapakita na ang kompetisyon sa HBM ay lumipat na mula HBM3E tungo sa HBM4.
Karaniwang tumaas ang demand sa HBM dahil sa limang dahilan:
- Mas malalaking bilang ng parameter ng modelo ay nangangailangan ng mas malapit na kapasidad ng memorya.
- Mas mahahabang context window ay mabilis na nagpapataas ng paggamit ng KV cache.
- Mas mataas na concurrency ng inference ay ginagawang hadlang sa kapasidad ng serbisyo ang memorya ng GPU.
- Ang MoE, RAG, at agentic AI ay nagpapataas ng pressure sa pag-access ng data.
- Habang tumataas ang compute ng GPU, kailangang tumaas din nang sabay ang memory bandwidth.
Buod: Ang HBM ang unang lugar na dapat panoorin pagkatapos ng mga GPU dahil direktang tumutukoy ito kung maaari bang mailabas ng mga high-end AI GPU ang kanilang performance. Ang mas mataas na compute peak, mas malaki ang pressure sa paggalaw ng datos. Ang mas malaking modelo, mas mahabang context, at mas mataas na inference concurrency, mas kritikal ang kapasidad at bandwidth ng HBM. Ngunit ang HBM ay hindi isang asset na walang panganib at patuloy na lumalago. Kailangan mo ring panoorin ang konsentrasyon ng mga customer, advanced packaging capacity, yield, contract pricing, technology iteration, at bilis ng pagpapalawak. Ang upside ng HBM ay nagmumula sa mga AI GPU, at ang mga panganib nito ay nagmumula rin sa AI GPU procurement cycles at supply expansion.
Anong Klase ng Storage ang Kailangan ng AI Training at AI Inference?
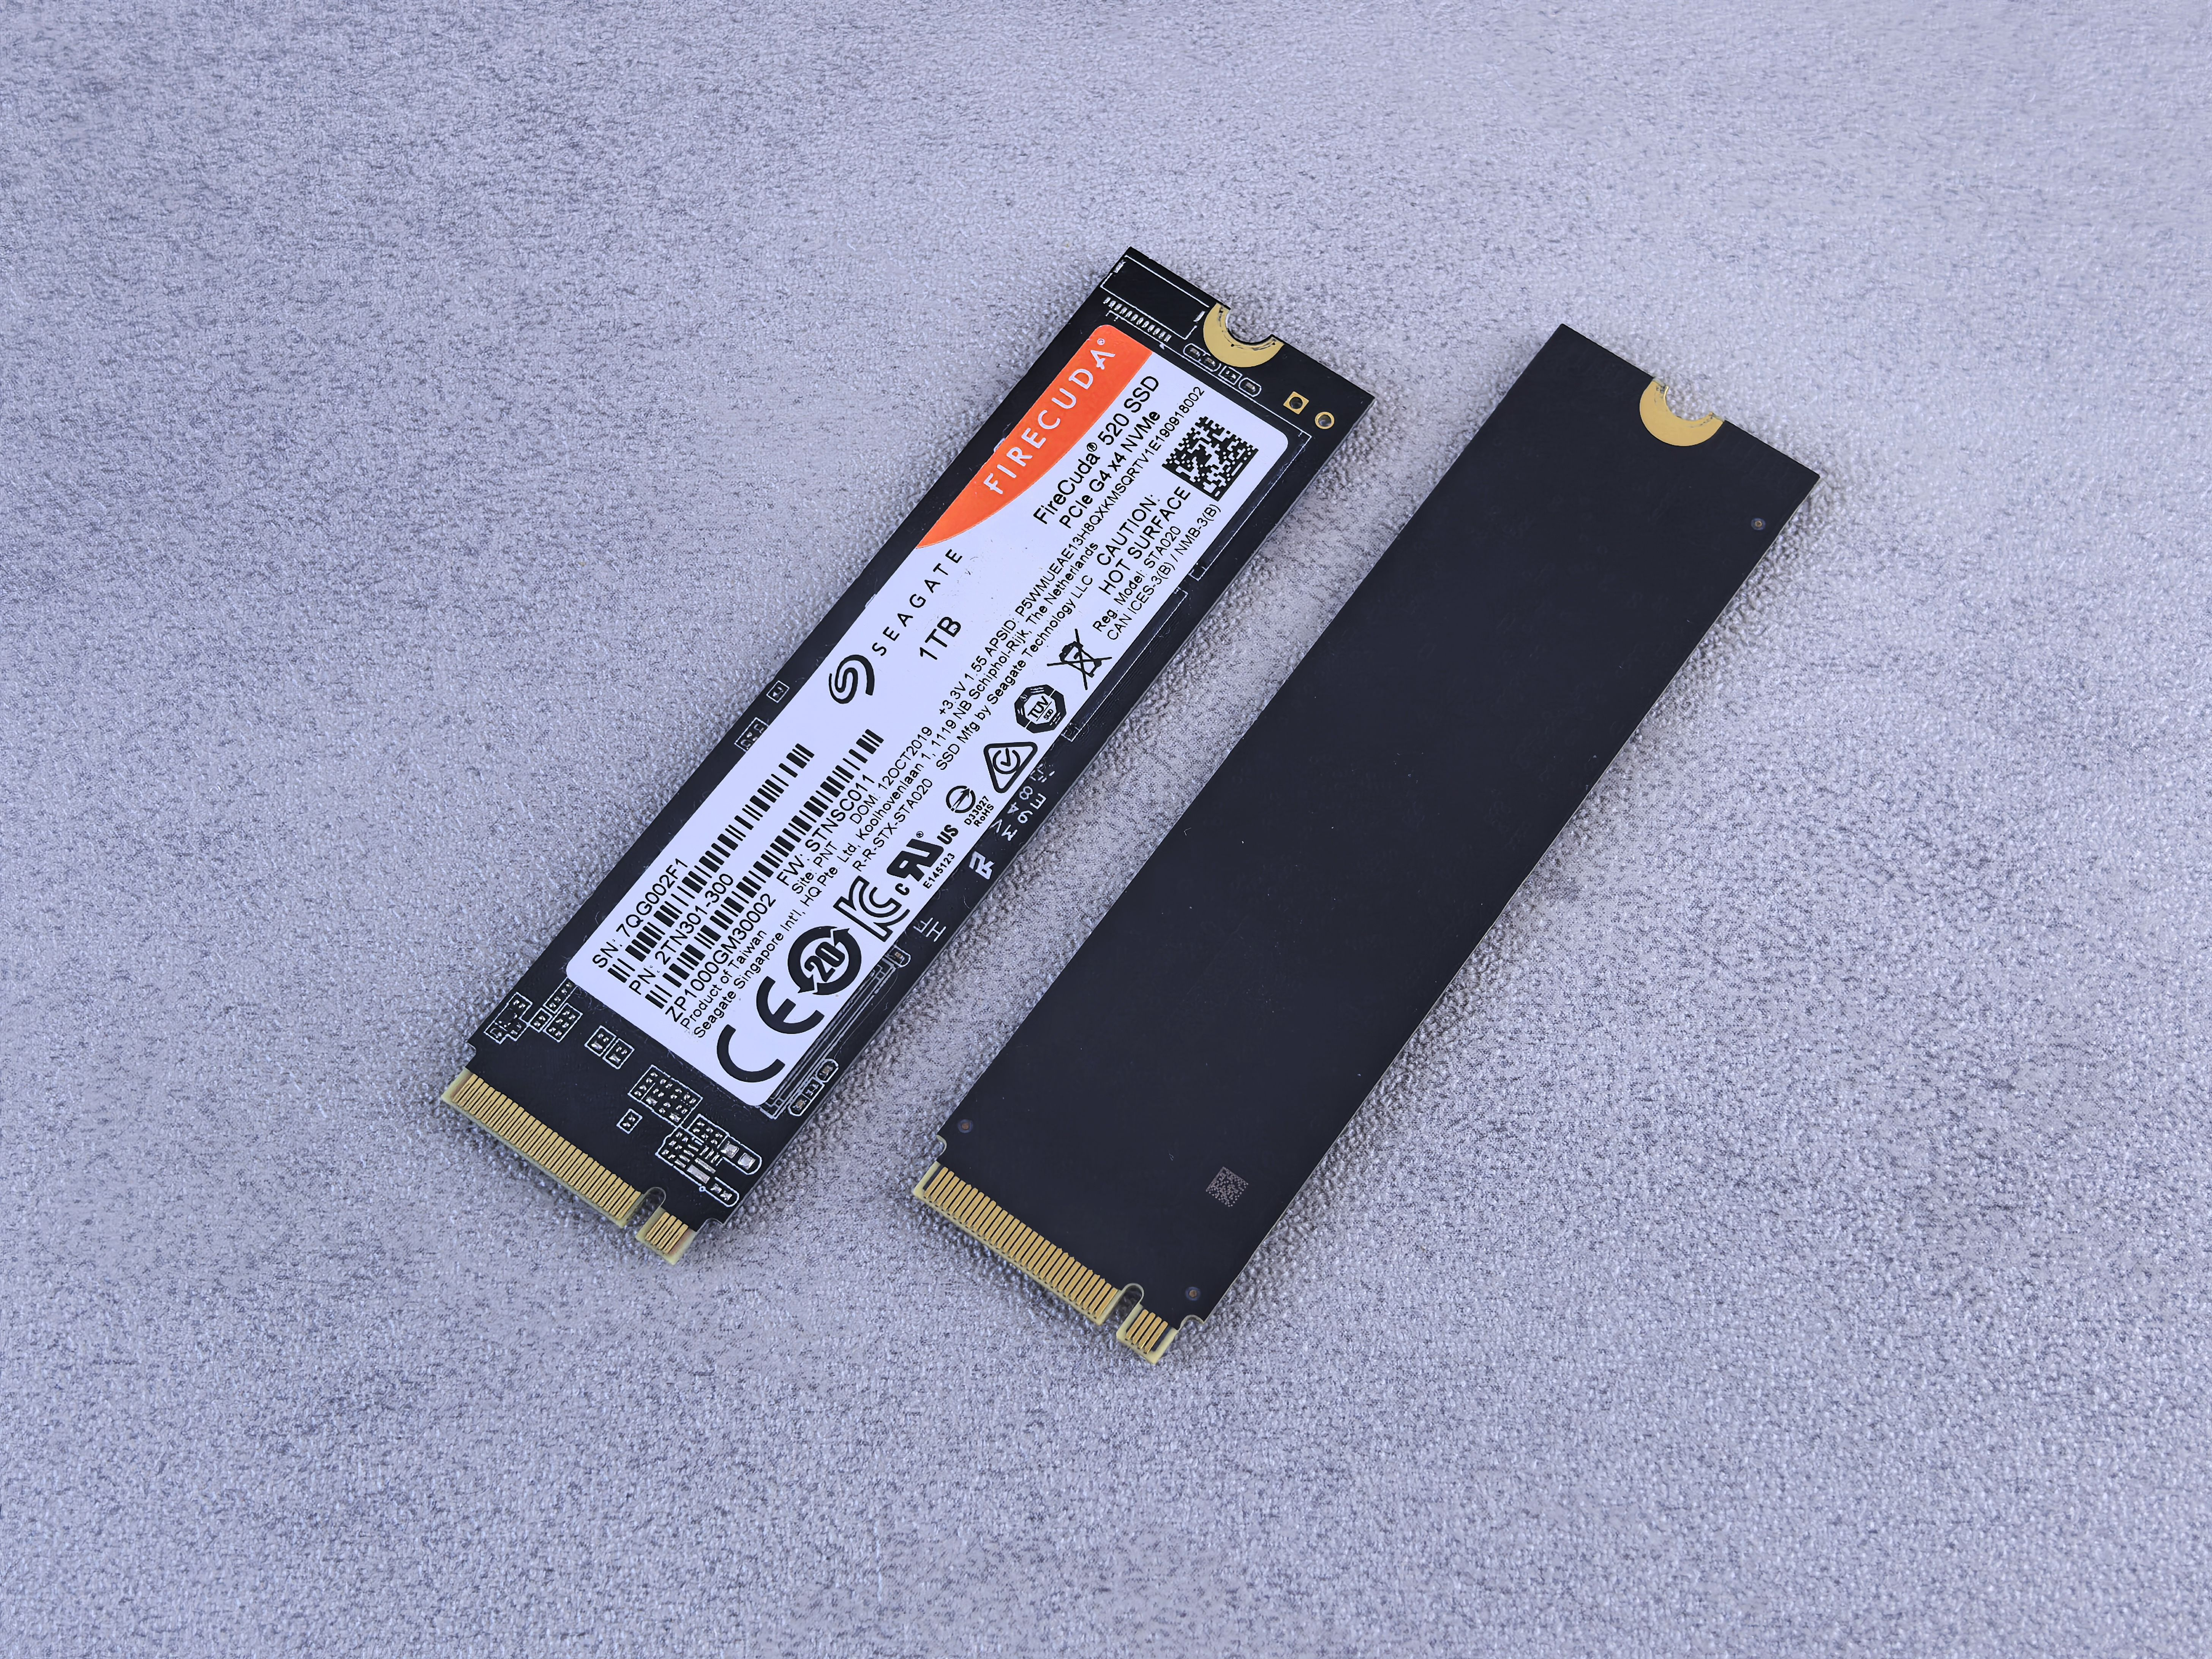
Ang AI training ay nangangailangan ng mataas na throughput at malaking kapasidad, habang ang AI inference ay nangangailangan ng mababang latency, concurrency, at access sa mainit na datos. Ang yugto ng training ay patuloy na nagbabasa ng napakalaking datasets, nagse-save ng checkpoints, at gumagawa ng mga intermediate na resulta. Ang yugto ng inference ay nagproproseso ng mga kahilingan ng user, context, KV cache, embeddings, vector databases, at RAG document retrieval.
Nakadepende ang AI Training sa Throughput, Kapasidad, at Matatag na Supply ng Datos
Hindi natatapos ang pagsasanay pagkatapos maisama ang data sa GPU nang isang beses. Ang pretraining ay nangangailangan ng napakalaking text corpora, multimodal data, at distributed file systems. Ang fine-tuning ay nangangailangan ng mga dataset na partikular sa industriya at inuulit na mga eksperimento. Sa panahon ng large-model training, kailangan ding i-save ang mga checkpoint para sa failure recovery at version rollback. Ang susi na sukatan dito ay hindi kung gaano kabilis ang isang drive, kundi kung kayang tuloy-tuloy na pakainin ng buong storage system ang GPU cluster.
Kabilang sa mga karaniwang pangangailangan sa storage sa pagsasanay ang:
| Uri ng Data | Pangunahing Gamit | Pangunahing Sukatan | Kaugnay na Storage |
|---|---|---|---|
| Hilaw na dataset | Pretraining at paglilinis | Kapasidad, gastos, pagkakatiwala | HDD, object storage |
| Nalinis na dataset | Input sa pagsasanay | Throughput, scalability | SSD, distributed file system |
| Checkpoint | Pagbawi mula sa pagkabigo | Bilis ng pagsulat, katatagan | SSD, object storage |
| Log at metrics | Pagsubaybay sa pagsasanay | Persistence, traceability | HDD, object storage |
| Panggitnang resulta | Pamamahala ng eksperimento | Performance sa pagbasa/pagsulat, pamamahala ng bersyon | SSD, DRAM |
Ang AI Inference ay Nakadepende sa Mababang Latency, Concurrency, at Hot Data
Kapag pumasok na ang inference sa komersyal na deployment, ang presyon sa storage ay lumilipat mula sa “paghahanda ng data bago ang training” patungo sa “patuloy na pagbasa at pagsulat ng data habang nagsasagawa ng operasyon.” Kailangang kunin ng RAG ang mga dokumento ng enterprise, kailangang basahin at isulat ng mga agent ang mga resulta ng tool, bumubuo ang mga long-context model ng malaking dami ng KV cache, at ang mga kahilingan at output ng user ay nagiging logs din. Ang paliwanag ng WEKA tungkol sa AI memory wall ay nakahuli sa pangunahing isyu: kapag lumampas sa available na physical GPU memory ang memory na kailangan para sa inference, apektado ang parehong latency at concurrency.
Sa mga inference scenario, ang HBM, DRAM, SSDs, at object storage ay bumubuo ng tiered na estruktura. Ang HBM ay nag-iimbak ng pinaka-madaling model-runtime data. Ang DRAM ay humahawak ng system caching. Ang NVMe SSDs ay sumusuporta sa vector databases at hot data. Ang HDDs at object storage ay nag-iimbak ng pangmatagalang data. Kapag nakikita mo ang "mas maraming AI applications," ang aktwal na lumalaki sa likod ng eksena ay tokens, embeddings, user logs, model versions, at audit records lahat nang sabay-sabay.
Buod: Magkaiba ang mga kinakailangan sa storage ng pagsasanay at inference. Mas para ang pagsasanay sa isang malaking proyektong pang-inhenyeriya na nangangailangan ng tuloy-tuloy, mataas na throughput, at nababawing paghahatid ng data. Mas para naman ang inference sa isang online service na nangangailangan ng mababang latency, mataas na concurrency, at access sa hot-data. Pagkatapos lumipat ng AI mula sa laboratoryo tungo sa mga production environment ng mga negosyo, hindi na nananatiling limitado sa training datasets ang demand sa storage. Lumalawak ito tungo sa vector databases, RAG document libraries, user interaction logs, model versions, audit records, at pangmatagalang data lakes. Dapat paghiwalayin sa pagsusuri ng pamumuhunan ang demand na pinapatakbo ng pagsasanay at ang demand na pinapatakbo ng inference sa halip na ituring na iisa ang lahat ng "AI storage."
Mula sa HBB tungo sa HDD: Paano Nahahati sa Mga Layer ang AI Storage Chain?
Ang AI storage chain ay maaaring i-layer ayon sa “layo mula sa GPU.” Kapag mas malapit ang isang layer sa GPU, mas maaasa ito sa bilis, bandwidth, at latency. Kapag mas malayo ito sa GPU, mas maaasa ito sa kapasidad, gastos, at pagiging maaasahan. Ang HBM ang mataas na halaga ng segment na pinakamalapit sa mga GPU. Ang DRAM at SSDs ay sumusuporta sa mainit na data sa loob ng mga server. Ang Nearline HDDs at object storage ay sumusuporta sa mga capacity pool ng data center.
Ang unang layer ay ang GPU-adjacent HBM. Pinangangasiwaan nito ang model weights, activations, KV cache, at high-frequency data access, na direktang nakaaapekto sa token throughput, context length, at concurrent inference. Ang pangalawang layer ay ang server-side DRAM at enterprise SSDs, na humahawak sa system caching, data preprocessing, vector retrieval, at high IOPS. Ang pangatlong layer ay ang data center capacity pool, kung saan iniimbak ng Nearline HDDs, object storage, at backup systems ang training data, logs, archives, at long-term data.
| Layer | Layo mula sa GPU | Kinakailangan sa Bilis | Gastos sa Capacity kada Unit | Karaniwang Paggamit |
|---|---|---|---|---|
| HBM | Pinakamalapit | Pinakamataas | Pinakamataas | Runtime ng modelo, KV cache |
| DRAM | Malapit | Mataas | Mataas | System cache, preprocessing |
| Enterprise SSD | Katamtaman | Medyo mataas | Katamtaman hanggang mataas | Vector databases, mainit na data, RAG |
| Nearline HDD | Mas malayo | Mas mababa | Mababa | Data lakes, backup, training data |
| Object storage | Pinakamalayo | Elastic | Mababa | Arkibo, mga log, pangmatagalang retention |
Ginagawa rin ng tiering na ito ang paliwanag kung bakit hindi pa tuluyang napapalitan ang mga HDD ng mga SSD. Kailangan ng mga AI data center ng malaking halaga ng mainit na data, ngunit mas malaking masa pa ng malamig at hangin na data ang kailangan nila. Hindi kayang itago ang lahat ng training corpora, mga video, mga larawan, mga bersyon ng modelo, mga log, at mga backup sa HBM o enterprise SSDs. Sa ikatlong quarter ng fiscal year 2026, iniulat ng Seagate ang kita na $3.112 bilyon at GAAP gross margin na 46.5%, na nagpapakita na ang mataas na demand sa storage ay nasasalamin na sa mga pinansyal na resulta ng mga tagagawa ng hard drive. Iniulat din ng Western Digital ang kita na $3.337 bilyon at GAAP gross margin na 50.2% sa ikatlong kuwarter ng fisal na taong 2026, na nagpapakita ng malinaw na pagpapabuti sa ikot ng cloud at data center storage.
Ang pangunahing tanong dito ay hindi kung “mapapalitan ba ng SSD ang HDD,” kundi “alinmang data ang dapat ilagay saan.” Habang lumalaki ang data ng AI, tumataas din ang mainit, malamig-init, at malamig na data. Mas mainam ang SSD para sa madalas na pagbasa/pagsulat, mababang-latency na pag-access, at vector retrieval. Mas mainam ang HDD para sa mababang-gastos na pag-iimbak ng napakalaking kapasidad. Sa karamihan ng mga kaso, mas malamang na magkasama ang dalawa sa tiered na paraan kaysa sa direktang magpalitan.
Buod: Ang pangunahing tuntunin ng AI storage chain ay simple: mas malapit ang data sa GPU, mas nagiging mahalaga ang bilis; mas malayo ito sa GPU, mas nagiging mahalaga ang kapasidad at gastos. Ang investment elasticity ng HBM ay nagmumula sa pagpapalabas ng performance ng AI GPU. Ang elasticity ng enterprise SSD ay nagmumula sa inference, RAG, at hot-data access. Ang elasticity ng nearline HDD ay nagmumula sa data lake, backup, log, at pagpapalawak ng kapasidad ng mga cloud provider. Kapag sinusuri ang iba't ibang kumpanya, hindi dapat itanong lamang kung ang mga ito ay "AI storage stock." Dapat din ninyong itanong kung anong storage layer ang kanilang hawak, gaano kalaki ang dependency ng kanilang kita sa presyo, sino ang kanilang mga customer, at kung maaari bang tumagal ang mahigpit na supply.
Anong mga Indikator ang Dapat Ninyong Panoorin sa AI Infrastructure Investment Chain?
Para masuri ang AI infrastructure chain, hindi maaaring tanging pagtuonan ang mga headline na nagsasabing "malakas ang demand sa AI." Ang mas praktikal na paraan ay panoorin ang tatlong pangkat ng mga indikator: sa panig ng demand, ang capital expenditure ng mga cloud provider at AI workloads; sa panig ng supply, ang kapasidad at yields ng HBM, NAND, at HDD; at sa panig ng pananalapi, ang paglago ng kita, gross margins, inventory, cash flow, at customer concentration.
Ang pinakamahalagang indikador sa panig ng demand ay ang hyperscaler capex. Ang pagpapatuloy ng mga cloud provider sa pagpapalawak ng mga AI data center ang nagtatakda ng kabuuang demand para sa GPUs, HBM, servers, SSDs, HDDs, at networking equipment. Ang mga gastusin na may kaugnayan sa training ay mas nakatuon sa mga GPU cluster at high-throughput storage. Ang mga gastusin na may kaugnayan sa inference ay mas binibigyang-diin ang cost, latency, hot data, at kahusayan ng mga online service. Hindi lamang dapat tingnan kung sinasabi ng isang kumpanya na "malakas ang AI demand." Kailangan din nitong makita kung ang mga order ay nagiging shipments, pricing, at gross margins.
Kailangang paghiwalayin ayon kategorya ang mga supply-side indicator. Ang HBM ay may hangganan dahil sa DRAM dies, TSVs, advanced packaging, yield, at customer qualification. Ang NAND ay apektado ng pricing cycle at demand sa enterprise SSD. Ang HDD ay nangangailangan ng atensyon sa HAMR, areal density, nearline exabyte shipments, at long-term supply agreements. Sa ikaapat na quarter ng fiscal year 2025, ang kita ng Cloud Memory Business Unit ng Micron na $4.543 bilyon at 59% gross margin ay nagpapakita na kapag umaagos ang demand ng AI data center sa product mix at presyo, maaaring maging napakalaki ang earnings elasticity.
| Indikasyon | Kahulugan para sa HBM | Kahulugan para sa SSDs/HDDs | Interpretasyon ng Pamumuhunan |
|---|---|---|---|
| CapEx ng cloud provider | Tumutukoy sa lakas ng pagkuha ng GPU/HBM | Tumutukoy sa pagpapalawak ng kapasidad ng data center | Pangunahing balbula ng demand |
| Mga kontrata ng HBM | Naka-lock ang presyo at kapasidad | Hindi direktang nakaaapekto sa suplay ng ordinaryong DRAM | Senyales ng mahigpit na supply at demand |
| Pagpopresyo ng NAND | Hindi direktang nakakaapekto sa gastos ng SSD | Direktang nakakaapekto sa kita ng enterprise SSD | Turning point ng cycle |
| Mga shipment ng Nearline | Hindi direktang nagpapakita ng paglaki ng data | Direktang nakakaapekto sa kita ng HDD vendor | Senyales ng demand sa kapasidad |
| Gross margin | Nagpapakita ng kapangyarihan sa pagpopresyo ng produkto | Nagpapakita ng pagpopresyo at product mix | Senyales ng earnings elasticity |
| Inventory | Nakakatulong na hukumin ang hindi pagtutugma ng supply-demand | Nakakatulong na hukumin ang posisyon ng cycle | Senyales ng panganib |
May isa pang dimensyon na madaling hindi mapansin: ang mga gastos sa transaksyon. Kapag nagsasaliksik ka ng mga AI infrastructure stock, bukod sa pagtataya sa fundamentals ng kumpanya, kailangan mo ring maunawaan na ang mga aktwal na gastos sa transaksyon ay maaaring makaapekto sa iyong karanasan sa paghawak at rebalancing ng mga hawak. Ang mga gastos sa pag-trade ng U.S. stocks ay karaniwang hindi limitado sa komisyon. Maaari rin nitong kabilangan ang platform fees, external agency fees, trading activity fees, at iba pang singilin. Ang Biya ay naniningil ng $0 komisyon sa pag-trade ng U.S. stocks, habang ang platform fees, external agency fees, at iba pang singilin ay ayon sa impormasyong ipinapakita sa U.S. stock trading fees at sa pahina ng order.Kung available ang mga kaugnay na serbisyo ay nakadepende sa lokasyon ng gumagamit, resulta ng pagpapatunay ng pagkakakilanlan, mga patakaran ng plataporma, at mga naaangkop na batas at regulasyon.
Kung kailangan mong subaybayan ang mga stock ng U.S. at Hong Kong sa buong AI storage chain, maaari mong gamitin ang Biya para sundan ang mga quote ng merkado, mga available na uri ng ari-arian, at mga gastos sa account. Maaari mo ring gamitin ang U.S. stock information search upang ayusin ang mga kaugnay na pangalan. Ang mga bayarin ay hindi ang salik na nagtatakda ng kita sa pamumuhunan, ngunit sa mga sitwasyong mataas ang volatility, madalas na rebalancing, o maliliit na pagbili, maaari nitong maapektuhan ang tunay na karanasan sa pangangalakal.
Buod: Ang pamumuhunan sa imprastruktura ng AI ay dapat lumipat mula sa "paghuhusga sa konsepto" patungo sa "pagpapatunay sa pamamagitan ng mga indikator." Sa panig ng demand, tingnan ang capex ng mga cloud provider, ang mga shipment ng AI server, ang inference concurrency, at ang enterprise AI deployment. Sa panig ng supply, tingnan ang HBM yield, ang advanced packaging, ang presyo ng NAND, at ang supply discipline ng HDD. Sa panig ng pananalapi, tingnan ang kita, ang gross margin, ang imbentaryo, ang cash flow, at ang istruktura ng mga customer. Lamang kapag ang demand ay tunay na dumadaloy sa mga order, sa pagpepresyo, at sa kita magiging mas matibay ang lohika ng pamumuhunan sa AI storage chain.
Anong Mga Panganib ang Dapat Mong Makita Habang Optimistiko Ka sa AI Storage Chain?
Ang pagiging bullish sa AI storage chain ay hindi nangangahulugang pagpapabaya sa mga cycle at valuation. Ang mga pangunahing panganib ay nahahati sa tatlong kategorya: mas mabagal na capital expenditure ng mga cloud provider, paglawak ng supply na nagpapababa sa mga presyo ng storage, at mga pagbabago sa teknolohiyang arkitektura na nagbabago sa istruktura ng demand. Malakas ang AI demand, ngunit ang DRAM, NAND, at HDD ay mayroon pa ring mga cyclical na katangian.
Ang unang panganib ay ang pagbagal ng AI capex. Kapag natuklasan ng mga cloud provider na ang kita sa inference, utilization ng compute, o availability ng kuryente ay kulang sa inaasahan, maaari munang lum podcasts ang capital spending. Ang mga GPU, HBM, server, SSD, at HDD ay pawang bahagi ng iisang chain ng infrastructure budget, at ang lakas o kahinaan ng demand ay maaaring kumalat sa maraming segment. Ang mga pansamantalang kakulangan sa supply ay hindi dapat ituring na direkta bilang permanente at mataas na kasaganaan, lalo na sa panahon ng mataas na valuation, kung kailan ang anumang pagbabago sa timing ng mga order ay maaaring magdulot ng volatility sa presyo ng mga stock.
Ang pangalawang panganib ay ang pagpapalawak ng supply. Ang mataas na presyo ng HBM ay naghihikayat sa mga tagagawa na palawakin ang kapasidad. Ang mas mataas na presyo ng NAND at HDD ay nagpapabuti rin sa kagustuhan ng industriya na mag-supply ng higit pa. Inilunsad ng South Korea ang mga malaking plano sa pamumuhunan sa paligid ng semiconductors, HBM, at AI data centers. Ang pagtatago ng Reuters sa plano ng South Korea sa pamumuhunan sa AI at chips ay nagpapakita ng estratehikong kahalagahan sa isang banda, ngunit nagpapaalala rin sa iyo na bigyang-pansin ang paparating na presyon ng cycle pagkatapos ng pagpapalawak ng supply.
Ang ikatlong panganib ay ang pagbabago ng teknolohikal na landas. Ang model quantization, sparsity, MoE, CXL memory pooling, KV cache offloading, at near-data processing ay lahat maaaring magpabago sa relatibong pangangailangan para sa HBM, DRAM, SSD, at HDD. Ang pag-optimize ng software ay maaaring mapabuti ang paggamit ng hardware, at maaari ring mabawasan ang pangangailangan sa hardware bawat yunit ng inference. Ang SSD at HDD ay hindi nasa simpleng relasyon ng pagpapalit. Sa hinaharap, mas malamang na paghihiwalayin ang mga ito ayon sa data temperature at gastos.
Dapat iwasan ng mga mamumuhunan ang mga pagkakamaling ito:
- Itinuturing ang lahat ng kumpanya ng storage bilang benepisyaryo ng HBM.
- Tinitingnan lamang ang paglaki ng kita habang hindi pinapansin ang gross margins at imbentaryo.
- Tinitingnan lamang ang AI training habang hindi pinapansin ang komersyalisasyon ng inference.
- Hindi pinapansin ang konsentrasyon ng mga customer at ang presyo ng pangmatagalang kontrata.
- Itinuturing ang cyclical na pagtaas ng presyo bilang permanenteng lohika ng growth stock.
- Tinitingnan lamang ang mga sikat na kumpanya habang hindi pinapansin ang valuation at cash flow.
Buod: Ang AI storage chain ay pinagsasama ang growth logic at cycle logic. Hindi ito isang low-risk na one-way na sektor. Ang HBM ay mas malapit sa growth ng AI GPU, ngunit mayroon din itong mas malalaking panganib sa customer concentration, packaging capacity, at technology iteration. Ang SSD at HDD ay mas naaapektuhan ng pricing cycles, inventory, at supply discipline. Ang mas maingat na paraan ay tingnan nang sabay-sabay ang industry momentum, supply at demand, valuation, at financial verification. Bago mag-trade, dapat mo ring maunawaan ang mga patakaran ng platform, ang fee structures, at ang iyong sariling risk tolerance. Ang impormasyon mula sa publikong merkado ay hindi bumubuo ng payo sa pamumuhunan.
Kung nakatuon ka sa pamumuhunan sa imprastruktura ng AI, hindi mo kailangang tumingin lamang sa mga pinuno ng GPU. Ang isang mas kumpletong balangkas ng pagmamasid ay ang pagtingin nang magkasama sa HBM, DRAM, NAND, enterprise SSDs, Nearline HDDs, kagamitan sa data center, capex ng mga cloud provider, at mga gastusin sa transaksyon. Maaari munang gamitin ang lohika ng industry chain upang sariwain ang mga direksyon, pagkatapos ay gamitin ang kita, gross margins, imbentaryo, at cash flow upang beripikahin ang cycle. Kung available ang mga kaugnay na serbisyo sa inyong rehiyon, maaari rin mag-register ng account upang higit pang galugarin ang suporta ng Biya sa multi-asset trading. Ang availability ng mga serbisyong tulad ng U.S. stocks, Hong Kong stocks, at digital assets ay nakadepende sa lokasyon ng gumagamit, resulta ng pag-verify ng pagkakakilanlan, mga patakaralan ng platform, at naaangkop na mga batas at regulasyon.Ang anumang desisyon sa pangangalakal ay dapat ibatay sa mga personal na layunin, antas ng pagpaparaya sa panganib, at kumpletong impormasyon tungkol sa mga bayarin.
FAQ
Bakit Hindi Dapat Ang AI Infrastructure Investors Ay Tumitingin Lamang sa GPUs?
Ang mga AI infrastructure investor ay hindi dapat tumitingin lamang sa GPUs dahil ang mga GPU ay nangangailangan ng HBM, storage, networking, power, at cooling upang gumana nang episyente. Ang mga GPU ang nagtatakda ng itaas na limitasyon ng compute, ngunit ang HBM ang nagtatakda kung maaaring mabilis na pumasok ang data sa compute unit, samantalang ang mga SSD at HDD ang nagtatakda kung maaaring ma-imbak at ma-access nang episyente ang training data, vector databases, at logs.
Ano ang Pagkakaiba ng HBM at Ordinaryong DRAM sa AI?
Ang HBM ay mas malapit sa GPU at nakatuon sa mataas na bandwidth, mababang latency, at mataas na density ng packaging. Ang karaniwang DRAM ay pangunahing nagsisilbi bilang system memory sa loob ng mga server. Ang AI training at inference ay kasangkot sa mabigat na paggalaw ng data, kaya ang HBM ay mas direktang nakaaapekto sa throughput ng high-end GPU, haba ng context, at concurrency ng inference.
Anong Demand sa Storage ang Pinapatakbo ng Paglago ng AI Inference?
Ang paglago ng AI inference ay nagtutulak ng demand para sa KV cache, vector database, RAG document library, user log, at hot-data access. Ang HBM at DRAM ay humahawak sa near-memory at system caching, ang enterprise SSD ay sumusuporta sa low-latency na pagkuha ng data, at ang HDD at object storage ay humahawak sa pangmatagalang pag-iimbak ng data.
Bakit Mahalaga pa Rin ang Nearline HDD sa mga AI Data Center?
Napakahalaga pa rin ng mga nearline HDD dahil nag-aalok ang mga ito ng mga pakinabang sa malalaking kapasidad at mas murang unit storage cost. Hindi lamang mabilis na hot data ang kailangan ng mga AI data center, kundi pati rin ang pangmatagalang imbakan para sa mga training corpus, log, backup, arkibo, at mga bersyon ng modelo. Para sa malamig at mainit-init na data, nananatiling mahalagang pundasyon ng kapasidad ang mga HDD.
Paano Makapaghatol ang Karaniwang Mamumuhunan sa mga Panganib ng mga AI Storage Stock?
Dapat tingnan ng karaniwang mamumuhunan ang demand, presyo, imbentaryo, gross margin, konsentrasyon ng customer, at valuation. Lubos na siklikal ang industriya ng storage, at ang maikling panahong pagtaas ng presyo ay hindi katumbas ng pangmatagalang katiyakan. Kapag kasama ang kalakalan, dapat ding isaalang-alang ang mga patakaran ng platform, detalye ng resibo, at mga kinakailangan sa lokal na regulasyon.
Mas Maganda ba ang AI Storage Chain para sa Pangmatagalang Pamumuhunan o Cycle Trading?
Kung angkop ba ang AI storage chain para sa pangmatagalang pamumuhunan ay nakasalalay sa posisyon ng kumpanya at sa personal na antas ng pagpapahintulot sa panganib. Ang HBM ay mas malapit na nauugnay sa paglago ng AI GPU, samantalang ang SSD at HDD ay mas naaapektuhan ng mga cycle ng presyo. Bago gumawa ng anumang kalakalan, dapat isaalang-alang ng mga mamumuhunan ang pinansyal na datos, pagtatalaga ng halaga, istraktura ng mga singil, at mga kinakailangan sa pagsunod nang magkasama.
*Ang artikulong ito ay ibinigay para sa pangkalahatang layunin ng impormasyon at hindi bumubuo ng legal, buwis, o iba pang propesyonal na payo mula sa BiyaPay o sa mga subsidiary at kaakibat nito, at hindi ito nilalayong maging kapalit ng pagkuha ng payo mula sa isang financial advisor o sinumang iba pang propesyonal.
Hindi kami gumagawa ng anumang pahayag o garantiya, hayag man o ipinahiwatig, hinggil sa katumpakan, kabuuan, o pagiging napapanahon ng nilalaman ng publikasyong ito.
Mga kaugnay na blog tungkol sa

International Money Transfer Limits: Per-Transfer, Daily, and Monthly Caps Explained


Online Bank-to-Bank Transfers: Account Linking, Steps, and Limits





Pumili ng Bansa o Rehiyon para Basahin ang Lokal na Blog
 Australia
 Austria
 Belhika
 Canada
 Siprus
 Republika ng Tsek
 Dinamarka
 Estonia
 Pinlandiya
 Pransiya
 Alemanya
 Gresya
 Hong Kong
 India
 Indonesia
 Ireland
 Italya
 Hapon
 Latvia
 Lithuania
 Luxembourg
 Malaysia
 Malta
 Morocco
 Nepal
 Olanda
 New Zealand
 Noruwega
 Pakistan
 Pilipinas
 Poland
 Portugal
 Romania
 Singapore
 Slovakia
 Eslobenya
 Timog Aprika
 Timog Korea
 Espanya
 Suwesya
 Taylandiya
 Estados Unidos
 Turkiya
 Nagkakaisang Arabong Emirato
 Nagkakaisang Kaharian
 Biyetnam