
GPUの後になぜHBMとストレージに注目するのか?AIインフラ投資チェーンの解説




AIインフラへの投資テーマは、「誰がGPUを持っているか」から「誰がGPUを効率的に稼働させ続けられるか」へと拡大しています。ピーク時の計算能力だけを見るべきではありません。HBMの帯域幅、GPUメモリ容量、エンタープライズSSD、ニアラインHDD、ネットワーキング、電力、そしてデータセンターストレージアーキテクチャにも目を向ける必要があります。一般の投資家にとって、GPUは入口であり、HBMとストレージはAI需要がインフラチェーン全体に広がり続けているかどうかを判断するための重要なシグナルです。
重要なポイント
- GPUがコンピュートの上限を決める一方で、HBMはモデルのスループットとデータ移動の効率を決定します。
- AIトレーニングはクラスタのスループットに依存し、AI推論はメモリ、レイテンシ、同時実行性により強く依存します。
- HBM、DRAM、SSD、HDDは、それぞれ異なるデータの温度帯とコスト上の位置づけに対応しています。
- ストレージ需要は、データセット、ベクトルデータベース、ログ、モデルの重み、推論出力から生まれます。
- 投資分析では、受注、価格、粗利益率、在庫、顧客の集中度に注目すべきです。
- AIストレージチェーンは成長の弾力性を提供しますが、景気循環の反転やバリュエーション圧縮のリスクにも直面しています。
なぜHBMとストレージはGPUの後に来るのか?
HBMとストレージがGPUの後に重要になるのは、AIシステムのボトルネックが「GPUが十分にあるかどうか」から「GPUが、十分に高速で、十分に近く、十分に大容量のデータを継続的に受け取れるかどうか」へと移行しつつあるためです。GPUは計算を担当しますが、モデルの重み、トレーニングデータ、KVキャッシュ、ベクトル検索、推論ログなどは、いずれも異なる階層のメモリとストレージのサポートを必要とします。
AIデータセンターを「AI工場」と考えることができます。GPUは中核となる生産ラインです。HBMはその生産ラインに付属する高速な材料倉庫です。DRAMはサーバー内部のバッファです。SSDはホットデータの倉庫です。HDDとオブジェクトストレージは大容量のデータレイクです。倉庫が小さすぎたり、コンベアベルトが遅すぎたりすると、高価なGPUであっても結局はデータを待つことになってしまいます。
NVIDIAの製品アップグレードにもこの傾向が表れています。NVIDIA H200の141GBのHBM3eと4.8TB/sの帯域幅は、ハイエンドAI GPUの競争がTensor Coreだけのものではなく、より大きなGPUメモリとより高い帯域幅をめぐるものでもあることを示しています。DGX B200の1,440GBのGPUメモリと64TB/sのHBM3e帯域幅は、この傾向をシステムレベルへと押し進めています。AIサーバーはすでに、GPU、HBM、NVLink、CPU、DRAM、NVMe SSD、そしてネットワーク機器の組み合わせとなっています。
| セグメント | 解決する主な課題 | AIへの影響 | 代表的な製品 |
|---|---|---|---|
| GPU | 行列計算 | トレーニングおよび推論速度の上限を決定 | AIアクセラレータ |
| HBM | 高速なメモリ近傍処理 | モデルのスループット、コンテキスト長、同時実行数に影響 | HBM3E、HBM4 |
| DRAM | システムメモリ | CPU、キャッシング、データ前処理をサポート | DDR5、RDIMM |
| SSD | ホットデータへのアクセス | ベクトルデータベース、RAG、キャッシング、高IOPSをサポート | エンタープライズSSD |
| HDD | 大容量ストレージ | データレイク、バックアップ、トレーニングデータ、ログをサポート | ニアラインHDD |
投資家にとって、これはAIインフラがもはやGPU単体の話ではなくなったことを意味します。データの流れを追う必要があります。データがどこから来るのか、どのように読み込まれるのか、どのようにキャッシュされるのか、どのようにGPUに入るのか、そして推論結果がその後どのように保存されるのか。GPUの受注だけを見ていると、HBMの供給、エンタープライズSSDの価格、ニアラインHDDの出荷、データセンターの設備投資の変化を見逃す可能性があります。
Blackwellアーキテクチャの2080億個のトランジスタと10TB/sのチップ間インターコネクトは、AIチップがシステムエンジニアリングの段階に入りつつあることを示しています。チップ内部のインターコネクト、パッケージング、HBM、サーバーメモリ、ラックレベルのネットワーキングが一体となって利用可能な計算能力を決定するのであり、単一のコンポーネントが単独で結果を左右するのではありません。
要約: GPUはAIインフラ投資の入り口ですが、終着点ではありません。本当に観察すべきは、コンピュートがデータを継続的に供給され続けられるかどうかです。HBMはGPU近傍の帯域幅と容量の問題を解決します。DRAMとSSDはサーバー側のキャッシングとホットデータアクセスを解決します。HDDとオブジェクトストレージは大量のデータ蓄積を解決します。GPUの後のHBMとストレージに着目することは、本質的に、AIがチップ調達からシステム展開へ、学習から推論へ、一時的な構築から長期的なデータ運用へと移行していく様子を見守ることなのです。
なぜHBMはAI GPUの重要なボトルネックになったのか?
HBMは、大規模モデルに必要なのは計算だけでなく高速なデータ移動でもあるため、重要なボトルネックとなっています。モデルのパラメータ、アクティベーション、KVキャッシュはすべて、GPU近傍のメモリとの間で頻繁に行き来する必要があります。通常のDRAMはGPUから離れた場所にあり、その帯域幅とレイテンシでは最上位のAIアクセラレータの要求を満たすことが困難です。HBMはスタッキングと高度なパッケージング技術を用いて、高帯域幅メモリをGPUの近くに配置します。
HBMが帯域幅とメモリ近接容量の問題を解決する
HBMは、単なる標準メモリモジュールの拡張版ではありません。GPUやAIアクセラレータ向けに設計された高帯域幅メモリ技術です。積層DRAMダイ、TSV、インターポーザー、先進的なパッケージング技術を通じて、HBMはより幅広いデータチャネルを演算ユニットの近くに配置します。その目的は単に容量を増やすことではなく、データ移動にかかる時間を短縮し、GPUが学習や推論の際に待機する時間を減らすことにあります。
Micron HBM3Eの24GB 8段積層キューブと1.2TB/s超の帯域幅は、HBMの中核的価値を反映しています。各HBMスタックは極めて高い帯域幅を提供し、GPUの周囲に複数のスタックを配置することで高スループットのメモリシステムを構成します。Blackwell Ultraにおいて、NVIDIAの技術ブログではGPUあたり288GBのHBM3eと8TB/sの帯域幅に言及しており、より大きなモデル、より長いコンテキストウィンドウ、より高い同時実行数の推論をGPU近傍のメモリ内で実行できるようにすることが明確な目標となっています。
なぜHBMはGPUバリューチェーンにより近いのか?
HBMはGPUに最も近いメモリ層であるため、その価格はAIアクセラレータの需要により直接的に影響を受けます。HBMは、主に一般消費者向け電子機器に販売される標準部品ではありません。その代わり、AI GPU、先端パッケージング、ウェハファウンドリ(受託製造)、基板、テスト、そしてクラウドプロバイダーの調達計画と緊密に結びついています。つまり、HBM需要の変化は、ハイエンドAIサーバーの実際の構築ペースをより直接的に反映するのです。
2025会計年度第3四半期において、MicronはHBM売上高が前期比で約50%増加し、データセンターセグメントの売上高が前年同期比で2倍以上に増加したことに言及しました。これは、AIが一部のストレージサイクル製品を、より付加価値の高いサーバーおよびデータセンターのユースケースへと押し進めていることを示しています。SK hynixも、12層HBM4サンプルを主要顧客に出荷し、認定後量産準備を進めると発表しており、HBMをめぐる競争がすでにHBM3EからHBM4へと移行していることがわかります。
HBM需要が高まる理由は、通常、次の5つです。
- より大きなモデルのパラメータ数は、より多くのニアメモリ容量を必要とします。
- より長いコンテキストウィンドウは、KVキャッシュの使用量を急速に増加させます。
- より高い推論同時実行数により、GPUメモリがサービス容量の制約になります。
- MoE、RAG、およびエージェンティックAIは、データアクセスの圧力を高めます。
- GPUの計算能力が増加するにつれ、メモリ帯域幅も同時に向上する必要があります。
要約: HBMは、GPUの次に注目すべき最初の領域です。ハイエンドAI GPUがその性能を発揮できるかどうかを直接左右するからです。計算ピークが高くなるほど、データ移動の圧力は大きくなります。モデルが大きく、コンテキストが長く、推論の同時実行数が高くなるほど、HBMの容量と帯域幅の重要性は増します。しかし、HBMはリスクのない一方方向的な成長資産ではありません。顧客の集中、先端パッケージング能力、歩留まり、契約価格、技術の反復、拡張のペースにも注目する必要があります。HBMの上振れはAI GPUからもたらされますが、そのリスクもまたAI GPUの調達サイクルと供給拡大からもたらされます。
AIトレーニングとAI推論にはどのようなストレージが必要か?
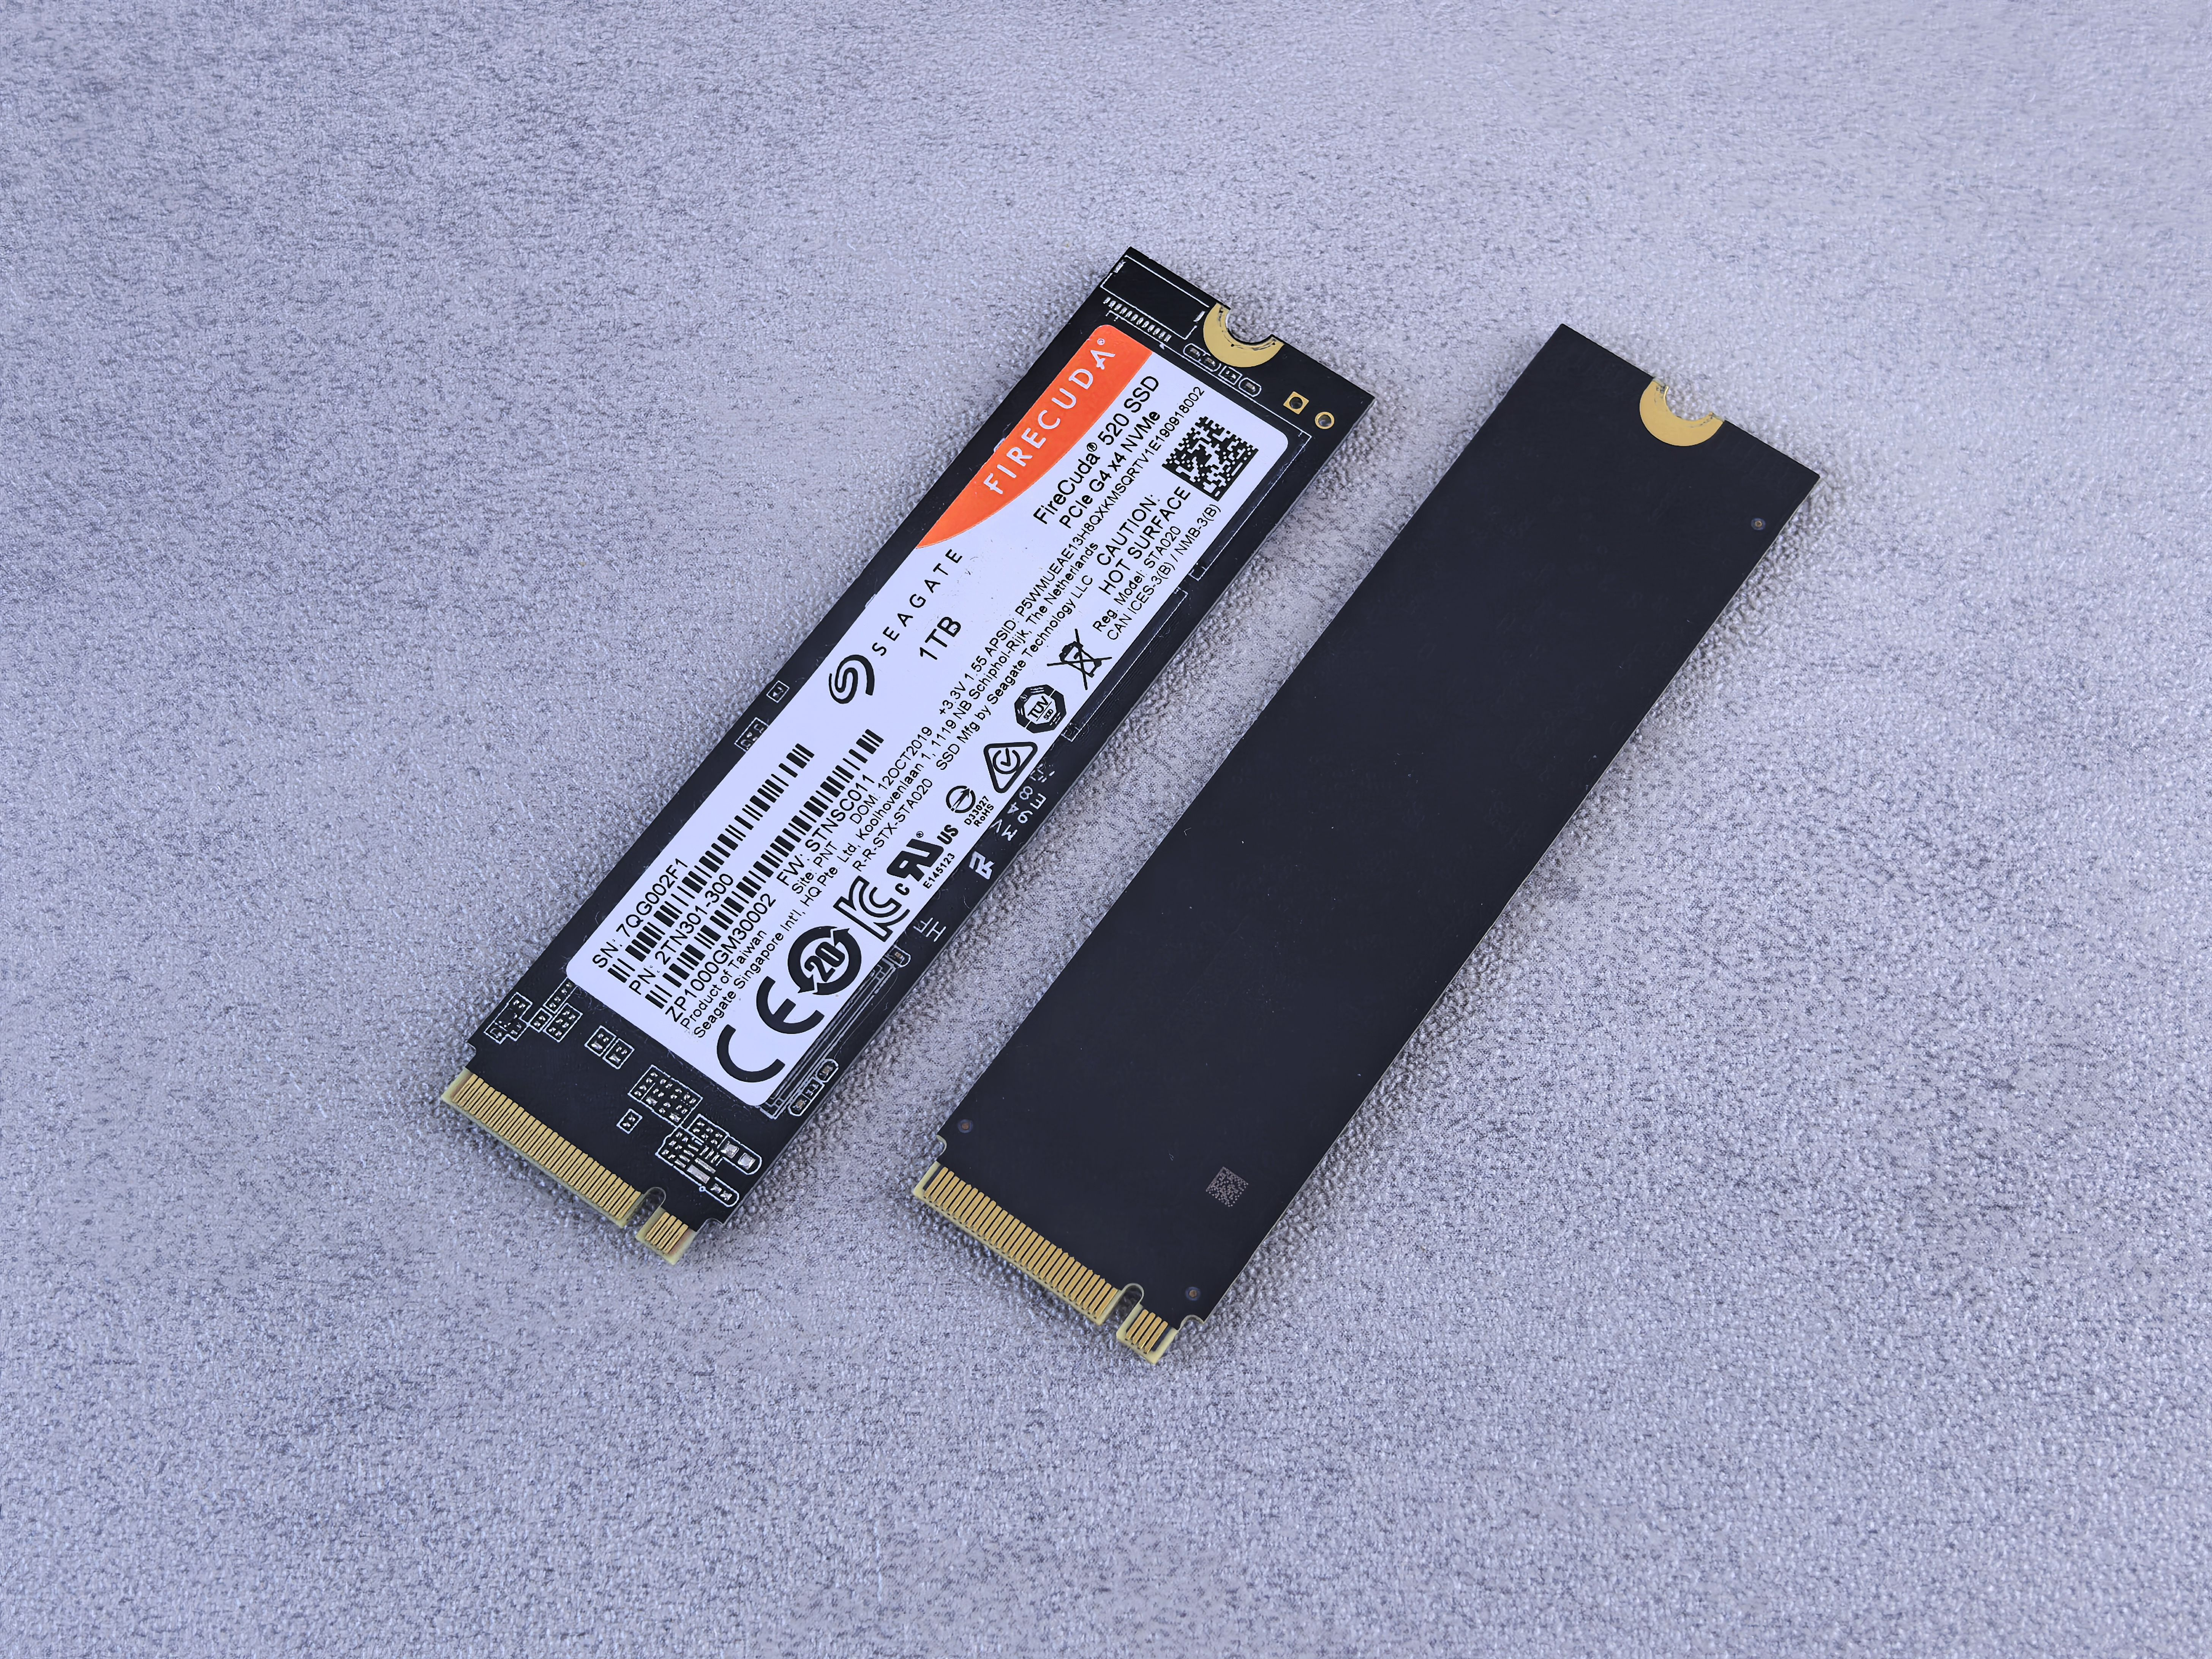
AIトレーニングは高スループットと大容量を必要とし、一方AI推論は低レイテンシ、同時実行性、ホットデータアクセスを必要とします。トレーニング段階では大量のデータセットを継続的に読み込み、チェックポイントを保存し、中間結果を生成します。推論段階では、ユーザーリクエスト、コンテキスト、KVキャッシュ、埋め込み、ベクトルデータベース、RAGドキュメント検索を処理します。
AIトレーニングはスループット、容量、安定したデータ供給に依存する
トレーニングは、データを一度GPUに入れたら終わりではありません。事前学習には大規模なテキストコーパス、マルチモーダルデータ、分散ファイルシステムが必要です。ファインチューニングには業界固有のデータセットと繰り返しの実験が必要です。大規模モデルのトレーニング中には、障害復旧やバージョンのロールバックのためにチェックポイントの保存も必要になります。ここで重要な指標は、単一のドライブが速いかどうかではなく、ストレージシステム全体がGPUクラスタに継続的にデータを供給できるかどうかです。
トレーニングにおける一般的なストレージのニーズは以下の通りです:
| データ型 | 主な用途 | 主要な指標 | 関連するストレージ |
|---|---|---|---|
| 生データセット | 事前学習とクリーニング | 容量、コスト、信頼性 | HDD、オブジェクトストレージ |
| クリーニング済みデータセット | 学習の入力 | スループット、スケーラビリティ | SSD、分散ファイルシステム |
| チェックポイント | 障害復旧 | 書き込み速度、安定性 | SSD、オブジェクトストレージ |
| ログとメトリクス | 学習の監視 | 永続性、トレーサビリティ | HDD、オブジェクトストレージ |
| 中間結果 | 実験管理 | 読み書き性能、バージョン管理 | SSD、DRAM |
AI推論は低レイテンシ、同時実行性、ホットデータに依存する
推論が商用展開に移行すると、ストレージへの負荷は「学習前のデータ準備」から「運用中の継続的なデータの読み書き」へと移行します。RAGは企業ドキュメントの取得を必要とし、エージェントはツールの結果を読み書きする必要があり、長いコンテキストを扱うモデルは大量のKVキャッシュを生成し、ユーザーのリクエストや出力もログとして蓄積されていきます。AIメモリの壁に関するWEKAの説明は、この重要な問題を捉えています。すなわち、推論に必要なメモリが利用可能な物理GPUメモリを超えると、レイテンシと同時実行性の両方に影響が及ぶのです。
推論シナリオでは、HBM、DRAM、SSD、オブジェクトストレージが階層構造を形成します。HBMは最も緊急性の高いモデル実行時データを格納します。DRAMはシステムキャッシュを担当します。NVMe SSDはベクトルデータベースとホットデータをサポートします。HDDとオブジェクトストレージは長期データを保存します。「AIアプリケーションが増えている」と目にするとき、その裏で実際に増加しているのは、トークン、エンベディング、ユーザーログ、モデルバージョン、監査レコードが同時にすべて増えているのです。
要約: トレーニングと推論ではストレージの要件が異なります。トレーニングは継続的で高スループットかつリカバリー可能なデータ供給を必要とする、大規模なエンジニアリングプロジェクトに近いものです。一方、推論は低レイテンシ、高同時実行性、ホットデータアクセスを必要とするオンラインサービスに近いものです。AIが研究室から企業の本番環境へと移行すると、ストレージ需要はトレーニング用データセットに限定されなくなります。ベクトルデータベース、RAGドキュメントライブラリ、ユーザーインタラクションログ、モデルバージョン、監査記録、長期データレイクへと拡大していきます。投資分析では、すべての「AIストレージ」を同一視するのではなく、トレーニング主導の需要と推論主導の需要を区別すべきです。
HBMからHDDへ:AIストレージチェーンはどのように階層化されているのか?
AIストレージチェーンは「GPUからの距離」によって階層化できます。GPUに近い層ほど、速度、帯域幅、レイテンシに依存します。GPUから遠い層ほど、容量、コスト、信頼性に依存します。HBMはGPUに最も近い高価値セグメントです。DRAMとSSDはサーバー内のホットデータを支え、ニアラインHDDとオブジェクトストレージはデータセンターの容量プールを支えます。
第1層はGPUに近いHBMです。モデルの重み、アクティベーション、KVキャッシュ、高頻度のデータアクセスを処理し、トークンスループット、コンテキスト長、同時推論に直接影響します。第2層はサーバー側のDRAMとエンタープライズSSDであり、システムキャッシング、データ前処理、ベクトル検索、高IOPSを担います。第3層はデータセンターの容量プールで、Nearline HDD、オブジェクトストレージ、バックアップシステムがトレーニングデータ、ログ、アーカイブ、長期データを保存します。
| レイヤー | GPUからの距離 | 速度要件 | ユニット容量あたりのコスト | 典型的な用途 |
|---|---|---|---|---|
| HBM | 最も近い | 最高 | 最高 | モデルの実行時、KVキャッシュ |
| DRAM | 近い | 高 | 高 | システムキャッシュ、前処理 |
| エンタープライズSSD | 中程度 | 比較的高 | 中〜高 | ベクトルデータベース、ホットデータ、RAG |
| ニアラインHDD | やや遠い | より低い | 低 | データレイク、バックアップ、トレーニングデータ |
| オブジェクトストレージ | 最も遠い | 弾力的 | 低 | アーカイブ、ログ、長期保存 |
この階層化は、HDDがSSDに完全に置き換えられていない理由も説明しています。AIデータセンターは大量のホットデータを必要としますが、それ以上に膨大なウォームデータとコールドデータを必要としています。トレーニングコーパス、動画、画像、モデルのバージョン、ログ、バックアップのすべてをHBMやエンタープライズSSDに保存することはできません。2026年度第3四半期、Seagateは売上高31億1,200万ドル、GAAP粗利益率46.5%を報告しており、大容量ストレージ需要がハードドライブベンダーの財務結果に反映されつつあることを示しています。Western Digitalも売上高33億3,700万ドル、GAAP粗利益率50.2%は2026年会計年度第3四半期に発表されたものであり、クラウドおよびデータセンター向けストレージサイクルの明確な改善を示しています。
ここでの重要な問いは「SSDがHDDに取って代わるかどうか」ではなく、「どのデータをどこに配置すべきか」です。AIデータが増加するにつれて、ホットデータ、ウォームデータ、コールドデータのすべてが増加します。頻繁な読み書きアクセス、低レイテンシーアクセス、ベクトル検索にはSSDが適しています。大容量の低コスト保存にはHDDが適しています。多くの場合、両者は互いを直接置き換えるというよりは、階層化された形で共存する可能性の方が高いのです。
要約: AIストレージチェーンの中核となるルールはシンプルです。データがGPUに近いほど速度の重要性が高まり、GPUから遠いほど容量とコストの重要性が高まります。HBMの投資弾力性は、AI GPUの性能発揮に由来します。エンタープライズSSDの弾力性は、推論、RAG、ホットデータアクセスに由来します。ニアラインHDDの弾力性は、データレイク、バックアップ、ログ、クラウドプロバイダーの容量拡張に由来します。異なる企業を分析する際には、それらが「AIストレージ株」であるかどうかだけを問うべきではありません。どのストレージ層を占めているのか、収益が価格設定にどれほど依存しているのか、顧客が誰なのか、供給逼迫が持続可能かどうかも問うべきです。
AIインフラ投資チェーンで注目すべき指標は何か?
AIインフラストラクチャーチェーンを評価するには、「AI需要は強い」といった見出しだけを見ていてはいけません。より実践的なアプローチは、3つのグループの指標を注視することです。需要側では、クラウドプロバイダーの資本支出とAIワークロード、供給側では、HBM、NAND、HDDの容量と歩留まり、財務側では、売上成長、粗利益率、在庫、キャッシュフロー、顧客の集中度です。
需要側で最も重要な指標は、ハイパースケーラーの設備投資です。クラウドプロバイダーがAIデータセンターの拡大を継続するかどうかが、GPU、HBM、サーバー、SSD、HDD、ネットワーク機器の総需要を左右します。トレーニング関連の出費は、GPUクラスターと高スループットのストレージにより集中します。一方、推論関連の出費は、コスト、レイテンシ、ホットデータ、オンラインサービスの効率性により重点を置きます。企業が「AI需要は強い」と言っているかどうかだけを見るべきではありません。受注が実際に出荷、価格設定、粗利益率につながっているかどうかも確認する必要があります。
供給側の指標はカテゴリー別に切り分けて捉える必要があります。HBMはDRAMダイ、TSV、先進パッケージング、歩留まり、そして顧客認定(クオリファイ)に制約されます。NANDは価格サイクルとエンタープライズSSD需要の影響を受けます。HDDについては、HAMR、面記録密度、ニアラインのエクサバイト出荷量、長期供給契約に注目が必要です。2025会計年度第4四半期において、Micronのクラウドメモリ事業部門の売上高45億4300万ドル、粗利益率59%は、AIデータセンターの需要が製品ミックスと価格に反映されるとき、収益弾力性が非常に大きくなり得ることを示しました。
| 指標 | HBMにとっての意味 | SSD/HDDにとっての意味 | 投資解釈 |
|---|---|---|---|
| クラウド事業者の設備投資 | GPU/HBMの調達強度を左右する | データセンター拡張能力を左右する | 主要な需要バルブ |
| HBM契約 | 価格と供給量を確保する | 間接的に汎用DRAMの供給に影響 | 供給逼迫のシグナル |
| NAND価格 | SSDコストに間接的に影響 | エンタープライズSSDの収益に直接影響 | 景気転換点 |
| ニアライン出荷 | データ増加を間接的に反映 | HDDベンダーの売上に直接影響 | キャパシティ需要のシグナル |
| 粗利益率 | 製品の価格決定力を反映 | 価格と製品ミックスを反映 | 収益弾力性のシグナル |
| 在庫 | 供給と需要のミスマッチ判断に有効 | 景気サイクルの位置判断に有効 | リスクシグナル |
見落とされがちなもう一つの要素があります。それは取引コストです。AIインフラ関連株を調査する際には、企業のファンダメンタルズを判断することに加えて、実際の取引コストが保有やリバランスの体験に影響を与えうることも理解しておく必要があります。米国株の取引コストには、通常、手数料以外にもさまざまな項目が含まれます。プラットフォーム手数料、外部機関手数料、取引活動費などの諸費用が含まれる場合があります。Biyaでは米国株取引の手数料を$0としていますが、プラットフォーム手数料、外部機関手数料、その他の諸費用については、米国株取引手数料および発注ページに表示される情報をご確認ください。利用可能な関連サービスは、ユーザーの所在地、本人確認の結果、プラットフォームの規則、および適用される法令によって異なります。
AIストレージチェーン全体にわたる米国株と香港株を追跡したい場合は、Biyaを利用して市場の相場、利用可能な資産クラス、口座コストを確認できます。また、米国株情報検索を利用して、関連銘柄を整理することもできます。手数料は投資リターンを決定する要因ではありませんが、高ボラティリティの状況、頻繁なリバランス、少額の買い付けなどの際には、実際の取引体験に影響を与える可能性があります。
要約: AIインフラ投資は「コンセプトの判断」から「指標の検証」へと移行すべきです。需要側では、クラウドプロバイダーの設備投資、AIサーバーの出荷台数、推論の同時実行数、企業のAI導入状況に注目します。供給側では、HBMの歩留まり、先端パッケージング、NAND価格、HDDの供給規律に注目します。財務側では、売上高、粗利益率、在庫、キャッシュフロー、顧客構成に注目します。需要が本当に注文、価格設定、そして収益に反映されて初めて、AIストレージチェーンの投資ロジックはより確固たるものになります。
AIストレージチェーンに強気でいる中で、どのようなリスクを見るべきか?
AIストレージチェーンに対して強気の見方をするからといって、サイクルとバリュエーションを無視するわけではありません。主なリスクは3つのカテゴリーに分けられます。クラウドプロバイダーの設備投資の減速、供給拡大によるストレージ価格の下落、そして需要構造を変えるテクノロジーアーキテクチャの変更です。AI需要は強いものの、DRAM、NAND、HDDには依然として循環的な特徴があります。
最初のリスクは、AI設備投資の減速です。クラウドプロバイダーが、推論収益、計算資源の稼働率、または電力供給が期待に届かないと判断した場合、資本支出は一時的に縮小する可能性があります。GPU、HBM、サーバー、SSD、HDDはすべて同じインフラ予算チェーンの一部であり、需要の強弱は複数のセグメントに波及する可能性があります。短期的な供給不足を恒久的な高好況と直接見なすべきではなく、特に評価水準が高い時期には、受注タイミングのわずかな変化が株価の変動を引き起こす可能性があります。
2つ目のリスクは供給拡大です。HBMの高価格はメーカーに増産を促します。NANDおよびHDD価格の上昇も、業界の供給意欲を高めます。韓国は半導体、HBM、AIデータセンターを中心に大規模な投資計画を打ち出しています。Reutersの韓国のAI・チップ投資計画に関する報道は、その戦略的重要性を示す一方で、供給拡大後の将来のサイクル圧力にも注意を払うよう促しています。
3つ目のリスクは技術経路の変化です。モデルの量子化、スパース性、MoE、CXLメモリプーリング、KVキャッシュのオフロード、データ近傍処理は、いずれもHBM、DRAM、SSD、HDDの相対的な需要を変える可能性があります。ソフトウェアの最適化はハードウェアの利用率を向上させる一方、推論1単位あたりのハードウェア需要を減らす可能性もあります。SSDとHDDは単純な代替関係にあるわけではありません。今後は、データの温度(使用頻度)とコストに応じた階層化がより可能性として高いといえます。
投資家は以下の誤りを避けるべきです:
- すべてのストレージ企業をHBMの受益者として扱うこと。
- 売上成長だけを見て、粗利益率や在庫を無視すること。
- AIトレーニングだけを見て、推論の商用化を無視すること。
- 顧客の集中度や長期契約の価格設定を無視すること。
- 循環的な価格上昇を永続的な成長株のロジックとして扱うこと。
- 人気企業だけを見て、バリュエーションやキャッシュフローを無視すること。
要約: AIストレージチェーンは成長ロジックとサイクルロジックを組み合わせたものであり、低リスクな一方向セクターではありません。HBMはAI GPUの成長に近いものの、顧客集中、パッケージング capacity、技術反復のリスクがより大きくなります。SSDとHDDは価格サイクル、在庫、供給規律の影響をより受けやすくなります。より慎重なアプローチは、業界の勢い、需給、バリュエーション、財務の検証を同時に確認することです。取引の前に、プラットフォームのルール、手数料体系、自身のリスク許容度についても理解しておく必要があります。公開されている市場情報は投資助言を構成するものではありません。
AIインフラへの投資に注目する場合、GPU大手だけを見る必要はありません。より完全な観察フレームワークは、HBM、DRAM、NAND、エンタープライズSSD、Nearline HDD、データセンター機器、クラウドプロバイダーの設備投資、そして取引コストを総合的に見ることです。まず産業チェーンのロジックで方向性を絞り込み、その後、売上高、粗利益率、在庫、キャッシュフローでサイクルを検証することができます。お住まいの地域で関連サービスが提供されている場合は、アカウントを登録して、Biyaのマルチアセット取引サポートをさらに詳しく調べることもできます。米国株、香港株、デジタル資産などのサービスが利用可能かどうかは、ユーザーの所在地、本人確認の結果、プラットフォームの規則、および適用される法令によって異なります。取引の判断は、個人の目標、リスク許容度、および手数料に関する完全な情報に基づいて行う必要があります。
FAQ
AIインフラ投資家はGPUだけを見るべきではないのはなぜですか?
AIインフラ投資家がGPUだけを見るべきではないのは、GPUが効率的に動作するにはHBM、ストレージ、ネットワーキング、電力、冷却が必要だからです。GPUはコンピュート性能の上限を決定しますが、HBMはデータがコンピュートユニットに素早く取り込めるかどうかを左右し、SSDやHDDは学習データ、ベクターデータベース、ログを効率的に保存・アクセスできるかどうかを決定します。
AIにおけるHBMと通常のDRAMの違いは何ですか?
HBMはGPUの近くに配置され、高い帯域幅、低レイテンシ、高密度パッケージングに重点を置いています。通常のDRAMは主にサーバー内のシステムメモリとして機能します。AIの学習と推論では大量のデータ移動が伴うため、HBMはハイエンドGPUのスループット、コンテキスト長、推論の同時実行数により直接的な影響を与えます。
AI推論の成長はどのようなストレージ需要を牽引するのか?
AI推論の成長は、KVキャッシュ、ベクトルデータベース、RAGドキュメントライブラリ、ユーザーログ、ホットデータアクセスへの需要を牽引します。HBMとDRAMはニアメモリおよびシステムキャッシュを担当し、エンタープライズSSDは低レイテンシの検索を支援し、HDDとオブジェクトストレージは長期的なデータ保持を担当します。
ニアラインHDDはなぜAIデータセンターにとって依然として重要なのか?
ニアラインHDDは、大容量と低い単位容量あたりのストレージコストという利点を持つため、依然として重要です。AIデータセンターには、高速なホットデータだけでなく、学習コーパス、ログ、バックアップ、アーカイブ、モデルバージョンなどの長期保存も必要とされます。コールドデータやウォームデータについては、HDDが依然として重要な容量基盤となっています。
一般の投資家はAIストレージ株のリスクをどう判断すればよいのか?
一般の投資家は、需要、価格、在庫、粗利益率、顧客の集中度、バリュエーションに注目すべきです。ストレージ業界は非常に景気変動が激しく、短期的な価格上昇は長期的な確実性を意味するものではありません。取引を行う際には、プラットフォームのルール、請求明細、そして現地の規制要件も考慮する必要があります。
AIストレージチェーンは長期投資向きか、それともサイクルトレーディング向きか?
AIストレージチェーンが長期投資に適しているかどうかは、企業のポジショニングと個人のリスク許容度によって異なります。HBMはAI GPUの成長とより密接に結びついていますが、SSDやHDDは価格サイクルの影響をより受けやすくなっています。取引を行う前に、投資家は財務データ、バリュエーション、手数料体系、コンプライアンス要件を総合的に考慮する必要があります。
*この記事は一般的な情報提供のみを目的としており、BiyaPayまたはその子会社および関連会社からの法務、税務その他の専門的助言を構成するものではなく、また、金融アドバイザーやその他の専門家から助言を受けることの代替を意図するものではありません。
当出版物の内容の正確性、完全性または適時性について、当社は明示または黙示を問わず、一切の表明および保証を行いません。
の関連ブログ

Crypto-Related Stocks vs Digital Assets: What Investors Actually Own


DCA vs. Grid Trading in Crypto: Key Differences, Costs, and Risks




 オーストラリア
 オーストリア
 ベルギー
 カナダ
 キプロス
 チェコ共和国
 デンマーク
 エストニア
 フィンランド
 フランス
 ドイツ
 ギリシャ
 香港
 インド
 インドネシア
 アイルランド
 イタリア
 日本
 ラトビア
 リトアニア
 ルクセンブルク
 マレーシア
 マルタ
 モロッコ
 ネパール
 オランダ
 ニュージーランド
 ノルウェー
 パキスタン
 フィリピン
 ポーランド
 ポルトガル
 ルーマニア
 シンガポール
 スロバキア
 スロベニア
 南アフリカ
 韓国
 スペイン
 スウェーデン
 タイ
 アメリカ合衆国
 トルコ
 アラブ首長国連邦
 イギリス
 ベトナム